
開発会社との打ち合わせで「AIを活用しているので、その分コストを抑えられます」と言われたことはないでしょうか。では、いくら抑えられるのか。何と比べてなのか。 ここを詰めると、たいてい話が曖昧になります。
2026年9月4日、GitHubが「Project HydraFusion」という仕組みを研究プレビューとして公開しました。1つの作業の中で複数のAIモデルを使い分けるもので、TerminalBench 2.1 では Claude Opus 5 と比べて推定モデル利用コストを67%削減しながら、正解率も4.9ポイント上げたと報告されています。
数字だけ見れば魅力的です。ただし、同時に公開された別のベンチマークでは品質がわずかに劣後しています。この「同じ発表の中に両方ある」状態こそが、AI開発費を考えるうえで一番実務的な材料です。
モデルを1つに決めない、という発想
これまでのAIコーディングは、どのモデルを使うかを先に決めて、全部の作業をそれでやる形でした。高性能なモデルを選べば品質は上がりますが、簡単な作業にも高い単価がかかります。
今回の仕組みは、作業が来るたびに進め方を組み立てます。 選ばれる形はおおむね3つです。
| 進め方 | 中身 | 向く作業 |
|---|---|---|
| 単独 | 1つのモデルだけで完結させる | 単純で迷いのない作業 |
| 段階的 | 軽いモデルが下書きし、品質の関門で上位モデルに上げるか判断 | 難易度が事前に読めない作業 |
| 相互批評 | 別系統のモデルが下書きを批評し、1回だけ直す | 見落としが致命的になる作業 |
ポイントは、高い単価を払う場面を作業単位まで絞り込んでいることです。人間のチームで、難しい判断だけ上位者に上げるのと同じ構造です。
数字は「1本だけ」を見ない
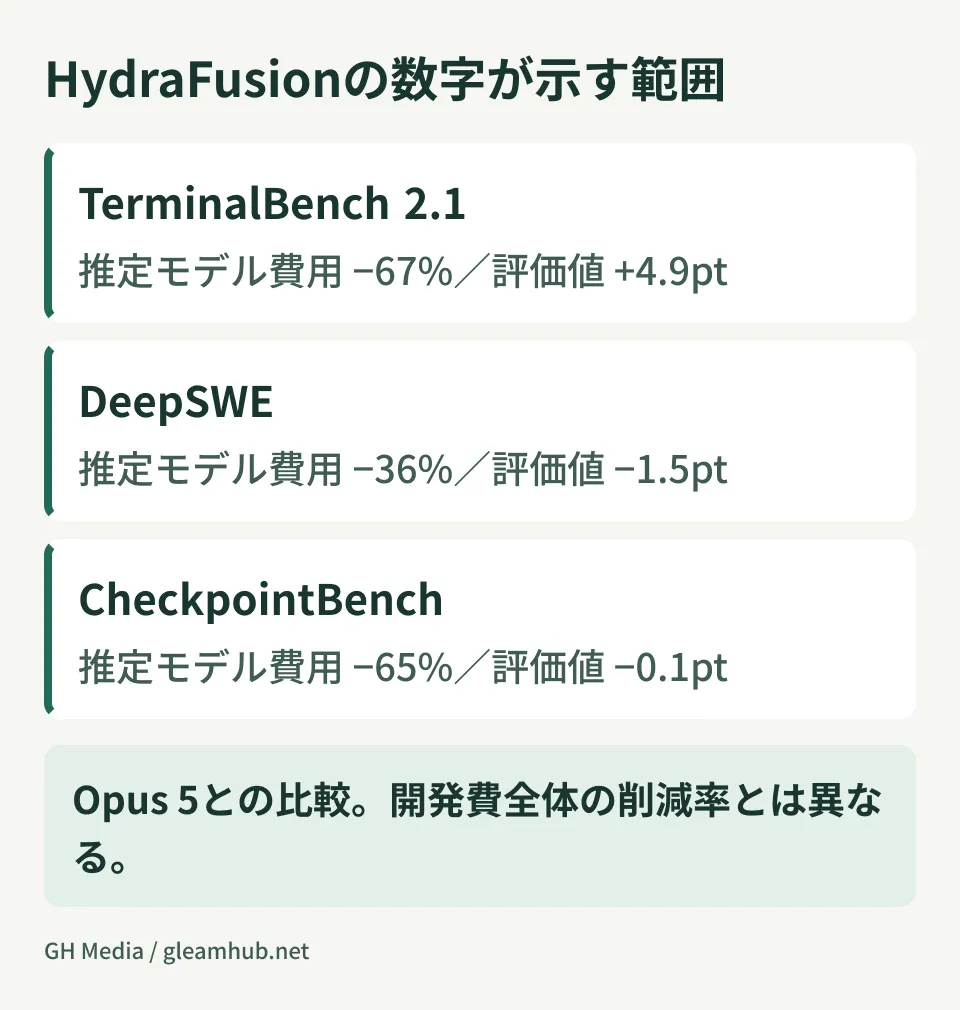
ここからが本題です。報告されている結果は次のようになっています。
| ベンチマーク | 推定利用コストの差 | 正解率の差 |
|---|---|---|
| TerminalBench 2.1 | 67%減 | +4.9ポイント |
| DeepSWE | 36%減 | -1.5ポイント |
| CheckpointBench | 65%減 | -0.1ポイント |
比較対象はいずれも Claude Opus 5 です。固定した条件でのオフライン評価であり、開発者の人件費・要件定義・レビュー・保守を含む開発費全体の削減率ではありません。誤差や個別タスクの影響もあるため、わずかな点差をそのまま実務上の優劣と断定しないでください。
つまり、コストは3本とも下がったが、品質で上回ったのは1本だけです。残る2本では「少し品質を落として、大きく安くした」という結果になります。
これは失敗という意味ではありません。用途と受け入れ基準によっては、検討できるトレードオフです。社内の管理画面を作るのと、決済処理を作るのとでは、許容できる品質の落ち幅がまったく違います。
問題になるのは、発注側に「67%減」だけが伝わり、どの作業でその取引をしたのかが伝わらない場合です。安くなった理由が「軽いモデルで済ませた」であれば、それがどこに適用されたのかを知らずに納品を受け取ることになります。
発注側・内製リーダーが聞くべきこと
AIを使ってコストを抑えると言われたときに確認したいのは、単価ではなく適用範囲です。
1つめ、どの作業を軽いモデルに任せたのか。 全体を一律に軽くしたのか、定型的な部分だけかで、リスクがまったく違います。
2つめ、品質の関門は何か。 段階的に上位モデルへ上げる仕組みには、必ず「上げるかどうかの判断基準」があります。その基準がテストの成功なのか、モデルの自己評価なのかは重要です。自己評価だけに頼る構成は、間違いに気づかないまま安く仕上がります。
3つめ、人のレビューはどこに入るか。 モデル同士の相互批評は、人のレビューの代わりにはなりません。批評する側も同じ種類の見落としをします。人のレビューで本当に効く指摘の種類は発注した開発の「レビューしてます」を鵜呑みにしないに整理しました。
なお、この仕組みの課金は使ったモデルのトークン量に応じた通常料金です。つまり、安くなるのは使い方の設計によるものであって、割引されるわけではありません。ここは誤解されやすい部分です。
内製チームが試すなら、比較の条件を先に決める
自社にエンジニアがいて試したい場合、この仕組みは研究プレビューとして Copilot CLI の実験機能から利用できます。すべてのプランで使えるため、試すこと自体のハードルは高くありません。
ただ、試す前に比較の条件を決めておかないと、結論が出ません。 よくある失敗は、それぞれ別の作業をやらせて「なんとなく速かった」で終わることです。
最低限、次の3つは揃えてください。
- 同じ作業を、同じ状態のコードに対してやらせる。 一度実行した後のコードに続けて実行すると、条件が変わります
- 完了したかどうかを、人の感覚ではなくテストで判定する。 動いたように見えて動いていない、が一番多い結果です
- かかったトークン量を記録する。 課金は使ったモデルの通常料金ベースなので、削減率は自社の作業内容によって変わります
社内でAIの運用に時間を取られている場合は、モデルの使い分けより先に手を付けるべき部分があるかもしれません。その切り分けはAIに週6時間「子守り」していませんかに整理しています。
「安く作れた」が後で高くつく場合
コストの話を締める前に、一点だけ付け加えます。
開発中の費用が下がっても、残ったコードの質が低ければ、後から払うことになります。 AIが速く書いたコードが半年後に手を入れられなくなる現象はAIに8割書かせたコードが半年で「腐る」で、消すのにも費用がかかる話は発注したシステムが「AIで速く作れた」のに、なぜ後で高くつくのかで扱いました。
見るべき数字は、開発期間中のAI利用料ではなく、2年間で自社が払う総額です。そこには保守と、作り直しの確率が含まれます。
次にやること
社内でAIコーディングを使っているなら、いま全部の作業を同じモデルでやっていないかを確認してください。 単価の高いモデルを定型作業にも当てている状態は、使い分けによって費用を下げられる余地があります。ただしルーティングの運用費も含めて比較します。使い分けの設計は、ツールを変えなくても今日から着手できます。
外部に開発を頼んでいるなら、「AIで安くなる」の内訳を1回だけ聞いてみてください。 答えが作業単位で返ってくる相手は、設計として使い分けています。「最新のAIを使っているので」しか返ってこない場合は、根拠が数字ではなく印象です。
AIを組み込んだ開発の進め方、モデル利用のコスト設計、既存コードの品質確認については、グリームハブの開発・AI・自動化のご相談で承っています。要件によって最適な構成は変わるため、個別にお見積りします。お問い合わせからご相談ください。
Sources
- Project HydraFusion: Frontier quality via multi-model orchestration — The GitHub Blog
- [Research Preview] HydraFusion is live in GitHub Copilot CLI — GitHub Community Discussions
- GitHub、Copilot CLIで複数AIモデルを使い分けてコスト削減を図る「Project HydraFusion」を研究プレビューで提供 — gihyo.jp
- GitHub’s HydraFusion cuts AI coding costs in every benchmark. It only matches quality in one. — VentureBeat


