
見積りを出すと、「AIを使えば半分になりませんか」と聞かれる。使っています、と答えると、では半分ですね、と話が進む。この会話に噛み合わない感じがあるのは、AIが効く作業と効かない作業の差が、発注側からは見えにくいからです。
その差を数字で見せてくれる材料が出てきました。2026年9月に公開された Real-SWE というベンチマークです。Y Combinator が出資する Specific Labs が作ったもので、公開リポジトリの課題ではなく、実在企業から利用許諾を得た非公開の本番コードベースから課題を採っています。コードもチケットも参照解も、公開インターネット上には存在しません。
結果は、公開ベンチマークの順位表とはかなり違う景色でした。
最高でも38.8%
8つのフロンティアモデルを、10件の実企業チケットに当てています。
| モデル | 達成率 |
|---|---|
| Claude Fable 5.1 | 38.8% |
| GPT-6 Astra | 33.8% |
| GPT-5.6 Sol | 16.2% |
最高でも4割に届きません。さらに、10件のうち1件(分析データのストリーム処理に関する課題)は、8モデル・延べ64回の試行すべてが失敗しています。
対象になったコードベースは、利用者20万人以上の一般向けプロダクトや、10万件以上の銀行明細を処理してきた金融系のプラットフォームなど、実際に事業を動かしているものです。
留意点も先に書いておきます。10タスクは統計的に小さく、ベンチマークの提供元自身が公表した数値です。この数字をそのまま「AIの実力は38.8%」と読むのは乱暴です。ここで見るべきは絶対値ではなく、公開ベンチマークとの差がどこから生まれているか、という構造のほうです。
差は「1件の修正が何ファイルに及ぶか」に出る
Real-SWE の解法が触るファイル数は、中央値で11ファイル。公開系のベンチマークでは6ファイル前後とされており、おおよそ倍です。
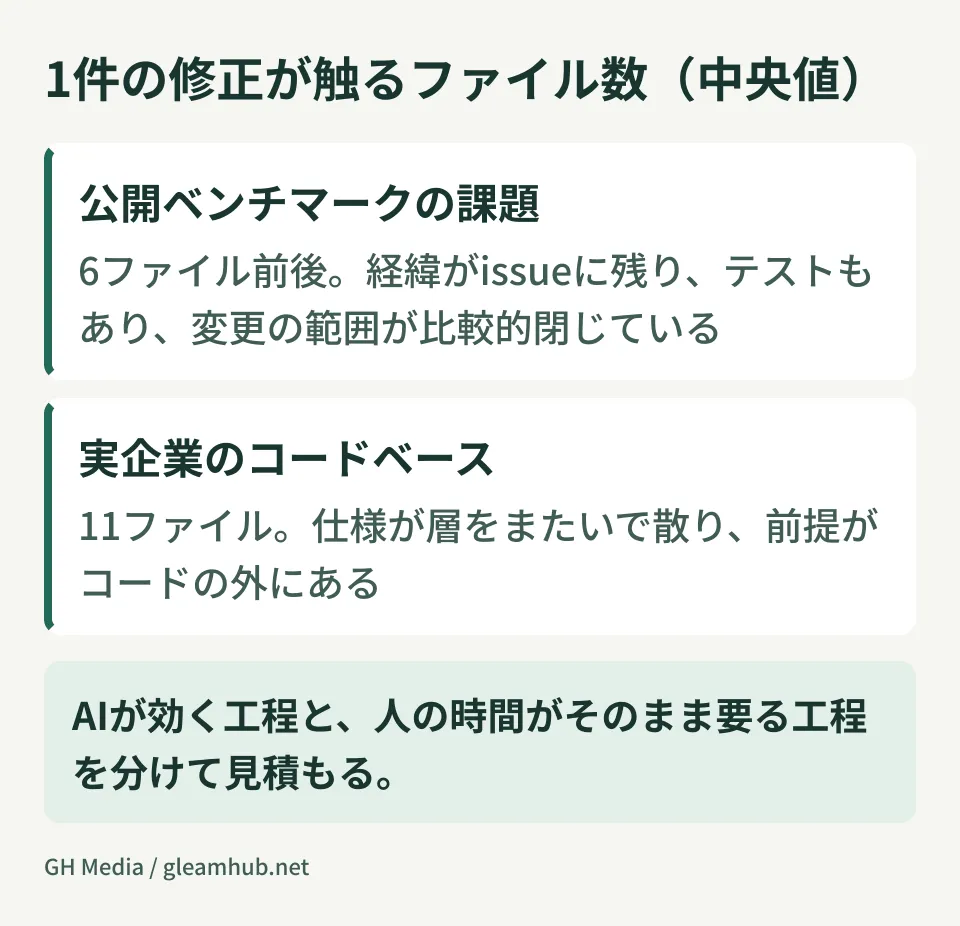
この差は、業務システムを触ったことがある人にはすぐ分かる形をしています。実際の修正は、たいてい1箇所で終わりません。入力のバリデーション、データの持ち方、集計側の扱い、画面の表示、既存データの移行、そして影響範囲のテスト。仕様の1行が、層をまたいで散っている状態です。
加えて、必要な情報がコードの外にあります。「この項目は2019年の制度変更以降は使っていない」「この分岐は特定の取引先のためだけにある」といった前提は、どこにも書かれていないか、書かれていても3年前の議事録の中です。Specific Labs は、実企業で扱われるトークンの99%はフロンティアモデルから見えていない、と推計しています。数字の精度はともかく、モデルが読める材料が圧倒的に少ないという方向は合っています。
公開ベンチマークの課題は、この点で条件が違います。リポジトリが公開されていて、issue に経緯が残り、テストがあり、変更の範囲が比較的閉じている。AIにとっては、材料が揃った状態です。
発注側が見積りに反映できること
ここから引き出せる実務的な結論は、「AIは使えない」ではありません。AIが効く条件が自社にあるかどうかで、見積りの読み方を変えるということです。
効きやすい作業と、効きにくい作業を分けます。
- 効きやすい: 新規に作る部分、テストの追加、定型的な変換や移行スクリプト、既存コードの説明、レビューの下読み
- 効きにくい: 長く運用された業務システムの仕様変更、暗黙の前提が多い箇所、複数チームの合意が要る変更、再現条件が不明な不具合
見積りの中でこの2つが混ざっていると、「AIで半分」の議論は噛み合いません。どの工程にAIが効いて、どの工程は人の時間がそのまま要るのかを分けて示せば、話は具体的になります。開発生産性を単一の数字で語ることの危うさは生成AIの導入効果を指標で測るときの落とし穴でも触れたとおりです。
もうひとつ、AIを使う側にもコストがあります。試行を繰り返す分の利用料、結果を確認する人の時間、失敗した変更を戻す手間。このあたりはAIエージェント基盤を作る前に見えないコストを数えるとAIコーディングの運用コストをどう抑えるかで扱った範囲と重なります。達成率が4割なら、6割は人が引き取るという前提で見積もるのが現実的です。
自社のコードを「AIが読める状態」にする
同じモデルでも、読める材料が増えれば結果は変わります。発注側が自社でできる準備があります。
- 仕様の前提を1箇所に書く。 「使っていない項目」「特定顧客向けの分岐」「過去の制度変更の経緯」。完璧な設計書は要りません。経緯を知っている人が消える前に、箇条書きで残すだけでも違います
- テストを増やす。 AIの変更が既存の挙動を壊していないかを機械的に確認できる状態は、人にとってもAIにとっても同じ価値があります
- 境界を明確にする。 どこまでが対象で、どこから先は触らないのか。これが曖昧な依頼は、人に出しても手戻りします
3つとも、AIのための投資というより、保守できる状態への投資です。結果としてAIも効くようになる、という順番で考えるほうが、費用の説明もしやすくなります。
ベンチマークの数字は、自社の数字ではない
最後に、この種のスコアの扱い方を書いておきます。
達成率は、モデルの性能だけで決まりません。どんな道具立てで動かしたかによって大きく変わります。参照できるファイルの範囲、テストを流せるか、失敗したときにやり直せる回数。同じモデルでも、環境が違えば結果は変わります。社内で「AIは4割しかできない」と断定するのも、「最新モデルなら大丈夫」と期待するのも、どちらも同じ理由で外れます。
自社で測るなら、やり方は単純です。直近でクローズした課題を3件選び、当時の情報だけを渡して再現させる。正解が分かっている課題なので、評価が容易です。3件のうち何件が通るか、通らなかったものは何が足りなかったのか。これが自社の数字になります。
このとき、通らなかった理由をメモしておいてください。「テストが無くて確認できなかった」「関連する処理の場所が分からなかった」。それがそのまま、次に整備すべき場所の一覧になります。
次にやること
自社の直近の変更依頼を3件思い出して、それぞれ何ファイルに手が入ったかを開発側に聞いてみてください。11ファイル前後が普通なら、AIによる短縮の期待値は控えめに置くのが妥当です。
そのうえで、「誰か1人しか知らない仕様」を挙げてください。そこが、AIにも新しい担当者にも渡せない部分です。渡せる形にする作業から着手すると、AIの効き方も変わります。
既存システムの仕様整理、AIを使った開発の適用範囲の切り分け、保守しやすい状態への段階的な移行については、グリームハブの開発・AI・自動化のご相談で承っています。システムの構成と履歴によって進め方が変わるため、お問い合わせからご相談ください。





