社内向けのAIチャットで、長めの回答が最後まで表示されるのを待つ時間が気になる。コードの修正案を出すツールで、開発者が生成を待って手を止めている。こうした「出力を待つ時間」を短くする手段として、Claude には高速モード(fast mode)があります。
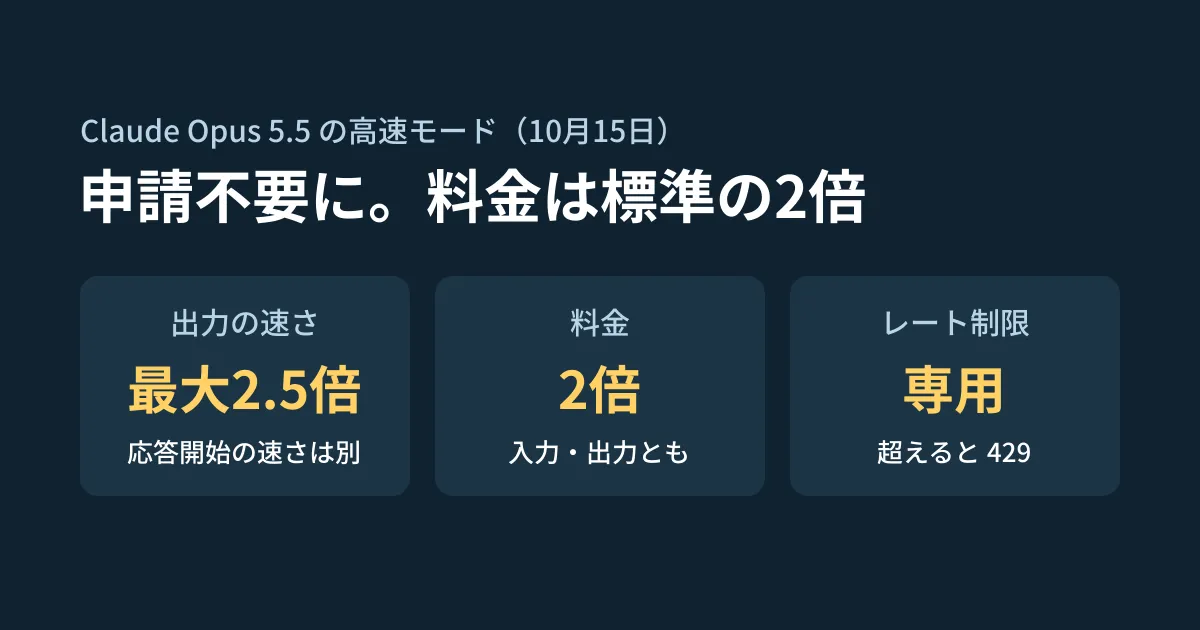
2026年10月15日、Claude Platform のリリースノートで、Claude Opus 5.5 の高速モードがリサーチプレビューを終えたと告知されました。これまで必要だったアクセスの申請とベータヘッダー(fast-mode-2026-02-01)が要らなくなり、Start・Build・Scale の利用ティアには既定のレート制限が付きます。
ただし、料金は標準の2倍で、速くなるのは処理の一部だけです。本記事では、公式ドキュメント(Fast mode、Pricing、Rate limits)の記述をもとに、使う前に決めておくことを整理します。
何が変わったか
リリースノートの記述をまとめると、次のとおりです。
- Opus 5.5 の高速モードは、申請もベータヘッダーも不要。ヘッダーを送り続けても動作する
- Opus 5.5 には、Start・Build・Scale の各ティアに既定の高速モードのレート制限がある
- Opus 5 と Opus 4.8 の高速モードは、引き続きリサーチプレビュー(申請とヘッダーが必要)
- 同じ日に、Microsoft Foundry の Azure でホストされるデプロイでも Opus 5.5 の高速モードが使えるようになった
使い方は、リクエストに speed: "fast" を足すだけです。
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    speed="fast",
    messages=[{"role": "user", "content": "..."}],
)
print(response.usage.speed)  # "fast" または "standard"
Claude Managed Agents では、エージェントの model をオブジェクトで指定し、{"id": "claude-opus-5-5", "speed": "fast"} とします。
速くなるのは「出力の速さ」だけ
ドキュメントは、高速モードを「同じモデルを、より速い推論の設定で動かす」ものとし、賢さや機能は変わらないとしています。そのうえで、効果の範囲を次のように限定しています。
- 出力のトークン毎秒(OTPS)が最大2.5倍
- 効果は出力の速さで、最初のトークンが返るまでの時間(TTFT)ではない
- 効果が最も見えるのはストリーミング
つまり、短い回答をすぐ返す用途より、長い回答や大きなコードを生成する用途で差が出ます。分類や短い要約のように出力が数十トークンの処理では、待ち時間の大半が最初の応答までの時間なので、2倍の料金に見合う短縮は期待しにくい、というのが編集部の見立てです(効果の実測はしていません)。
料金は入力・出力とも標準の2倍
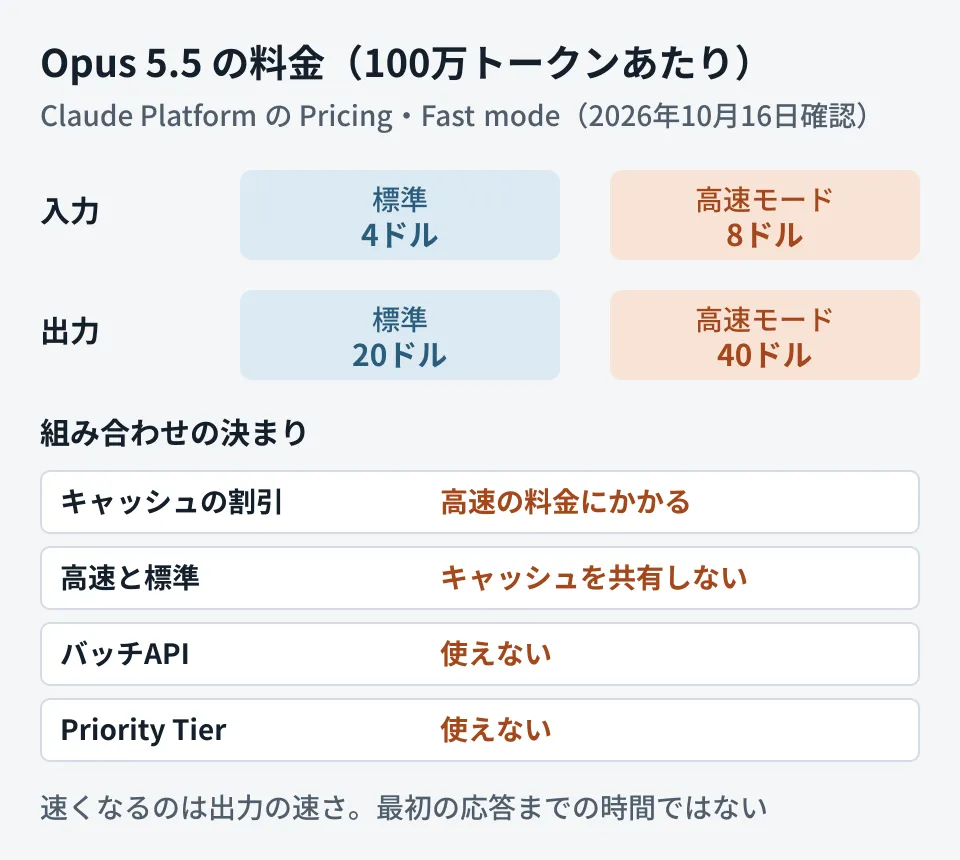
料金ページによると、Opus 5.5 の標準料金は入力が100万トークンあたり4ドル、出力が20ドルです。高速モードは入力8ドル、出力40ドルで、どちらもちょうど2倍です。この料金はコンテキストの全範囲(20万トークンを超える入力を含む)に適用されます。
ほかの割引・割増との関係は次のとおりです。
- プロンプトキャッシュの倍率は、高速モードの料金の上にかかる
- データレジデンシーの倍率も、高速モードの料金の上にかかる
- バッチAPIでは使えない(半額のバッチと組み合わせられない)
編集部の試算で、入力2万トークン・出力2,000トークンのリクエストを1回送ると、標準は0.08ドル+0.04ドル=0.12ドル、高速モードは0.24ドルです(キャッシュなし)。1日1,000回なら、差は1日あたり120ドルになります。どの処理に使うかを絞らないと、請求額がそのまま倍になります。
決めること1:どの処理に使うか
上の性質から、編集部としては次の条件で対象を絞ることを提案します。
- 出力が長い(数百トークン以上)
- 人が画面の前で待っている(チャット、エディタの補完、レビューの生成など)
- ストリーミングで表示している
夜間のバッチ処理や、結果をあとで読む処理は、そもそも高速モードを使えないバッチAPIか、標準の速さで十分です。また、Opus 5.5 である必要がない処理は、高速モードより先に、より安いモデル(Sonnet 5.5 や Haiku 5.5)に替えられないかを検討します。モデルの選び方はClaude Opus 5 のモデル選び、値下げや価格差を請求額にどう反映させるかは安い新モデルが出ても、請求額は自動では下がらないで整理しています。
決めること2:レート制限を超えたときの扱い
高速モードには、標準の Opus とは別のレート制限があります。超えると 429 エラーと retry-after ヘッダーが返ります。応答ヘッダーの anthropic-fast-input-tokens-remaining などで残りを確認でき、Claude Console の Rate limits のページで上限を見られます。
超えたときの選択肢は2つです。
- 待って再試行する:SDK は既定で2回まで自動で再試行します。ドキュメントは、高速モードは継続的に枠が戻るため、待ち時間は通常短いとしています
- 標準の速さに切り替える:再試行を0回にして、エラーを受けたら
speedを外して送り直す
切り替える場合の注意点として、ドキュメントは「高速と標準ではプロンプトキャッシュを共有しない」と書いています。長いシステムプロンプトをキャッシュしている処理で速さを行き来すると、そのたびにキャッシュの書き込みが発生します。キャッシュの効果が大きい処理では、どちらかに固定するほうが安く済む場合があります。
なお、Evaluation ティア(新しい組織や利用履歴の少ない組織が最初に置かれることがあるティア)では、Opus 5.5 の高速モードは使えません。Start・Build・Scale に上がると使えるようになります。
決めること3:使える経路か
高速モードは、どこから Claude を呼んでも使えるわけではありません。ドキュメントの記載は次のとおりです。
| 経路 | Opus 5.5 の高速モード |
|---|---|
| Claude API(Managed Agents を含む) | 使える |
| Microsoft Foundry(Azure でホスト) | 使える |
| Microsoft Foundry(Anthropic でホスト) | 使えない |
| Claude Platform on AWS | 使えない |
| Priority Tier の契約 | 使えない |
料金ページは、Claude Platform on AWS と「partner-operated cloud platforms」では使えないとしており、Fast mode の対応表にも Amazon Bedrock と Google Cloud(Vertex AI)は載っていません。社内システムがどの経路で Claude を呼んでいるかを先に確認します。
組み込んだあとの確認
実際に高速モードで処理されたかは、応答の usage.speed で確認できます。"fast" なら高速モード、"standard" なら標準です。対応していないモデルに speed: "fast" を送るとエラーになります(例外として、Opus 4.6 にベータヘッダー付きで送った場合はエラーにならず標準で処理され、usage.speed は "standard" になると書かれています)。
編集部の提案として、ログに usage.speed と出力トークン数を残し、次の2点を週ごとに見ておくと、費用の増え方を把握しやすくなります。
- 高速モードの呼び出しのうち、出力が短いもの(効果の薄い使い方)の割合
- 429 による標準への切り替えの回数(レート制限の不足)
AIの呼び出しを社内のシステムからまとめて管理する設計は、社内AIにゲートウェイを1枚挟むかで扱っています。
確認した範囲
2026年10月16日に、Claude Platform のリリースノート(October 15, 2026)、Fast mode・Pricing・Rate limits・Managed Agents の Agent setup のドキュメントを直接取得して確認しました(資料調査)。高速モードでの実際の呼び出し、速さや費用の実測、レート制限の具体的な値は確認していません。本文の試算は、料金ページの単価から編集部が計算したものです。
Claude API を組み込んだシステムの速度と費用の設計、モデルの切り替えは、開発・AI・自動化のご相談からお問い合わせください。