機密の資料を外部の API に送りたくない。月の利用料を読みやすくしたい。そうした理由で、Gemma や Qwen のような重みが公開されたモデル(オープンウェイトのモデル)を、自社のサーバーやクラウドの中で動かす計画が出てきます。
そのときに抜けやすいのが、API の事業者が裏で用意していた統制です。不適切な出力の検知、利用の監視、乱用への制限などは、自社で動かす場合、自社で用意することが多くなります。
Microsoft と NVIDIA は2026年10月、この点を整理した共同の文書「Risk Management for Open-Weight Models in Enterprise」(版1.0。10月27日に版1.0.1へ更新)を公開しました。NVIDIA の GitHub のリポジトリで、文書とリスクの分類(タクソノミー)が公開されています。この記事では、文書の内容をもとに、社内でモデルを動かす前に決めることを整理します。
文書の立場:重みの公開だけでは危険は決まらない
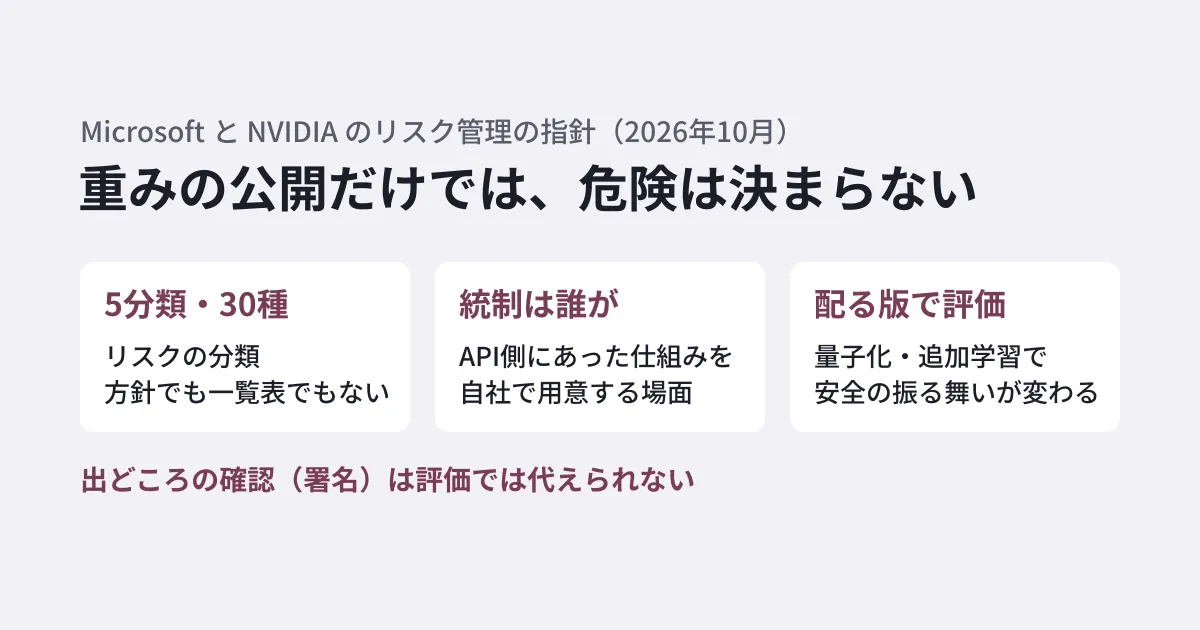
文書の中心にあるのは、「重みが公開されているかどうかだけでは、AI システムの危険の大きさは決まらない。モデル、用途、配備の仕方、安全策で決まる」という考え方です。
そのうえで、違いが出るのは「誰が統制を用意するか」だと説明しています。重みが非公開のモデルは、安全のための仕組み、セキュリティの監視、キャッシュなどと組み合わせて提供されることが多い。一方、オープンウェイトのモデルは、重みのファイルだけで配られることが多く、同じ水準にするには追加の組み込みが必要になる。統制の中身はほぼ同じでも、用意する人が変わる、という整理です。
また、モデルの入手と配備の仕方は別の選択だとも書いています。オープンウェイトのモデルを、クラウドの管理された基盤で動かすこともでき、その場合はサービスと設定によって責任の分担が変わります。
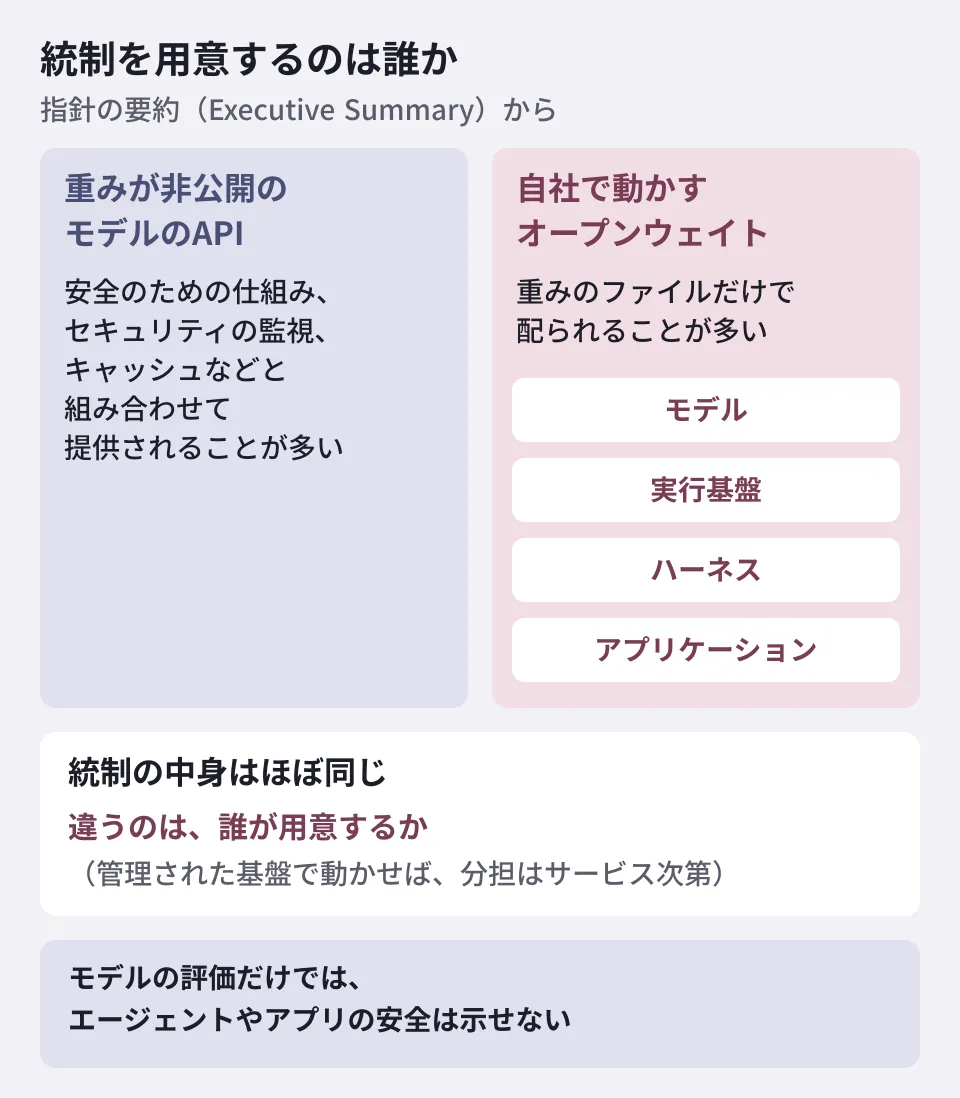
文書は、統制を置く場所を、モデル、実行基盤(ランタイム)、ハーネス、アプリケーションの4つの層で説明しています。ただし、この最初の文書が詳しく扱うのはモデルの層で、残りの層は今後の文書で扱う予定としています。「モデルの評価だけでは、エージェントやアプリケーションの安全は示せない」とも明記されています。
5分類30種のリスク分類
リスクの分類は、上位の5つの分類(L1)と、30の種類(L2)でできています。
- サイバーセキュリティ(5種): 脆弱なコードや悪意のある依存を含むコードの生成、道具(ツール)の想定外の呼び出し、過剰なトークンの生成など
- データ保護(6種): 学習データの開示、個人情報の開示、推測による機微な情報の復元、モデルの盗用、複数の利用者の間の分離の失敗など
- コンテンツ(7種): 有害な内容、著作物の再現、根拠のない内容(情報の正確さ)など
- 人とAIのやり取り(7種): 操作、欺き、過度の依存、迎合など
- バイアス(5種): AIによるプロファイリング、描写の偏り、思想的な偏り、検閲など
文書は、この分類を「方針でもチェックリストでもない」としています。自社の用途に合わせて取捨選択し、各リスクに担当者を置き、評価と対策に結び付けるための共通の言葉、という位置づけです。脱獄やプロンプトインジェクションのような手法は、サイバーセキュリティのリスクにつながり得るものとして、分類そのものからは外しています。
社内と販売店に公開する推論の窓口という例
文書は、具体例として「道具を呼ばない、モデルだけの推論の窓口」を挙げています。産業機器のメーカーが、オープンウェイトのモデルを社内の共有の文章サービスとして動かし、現場の報告の要約、14の言語への翻訳、問い合わせの分類に使う。同じ窓口を、契約した販売店にも公開する、という設定です。
文書は、統制はもっとも確実に効かせられる場所に置くべきで、この構成ではそれが次の2つの層だと説明します。
- モデルの層: 有害な内容の生成、脱獄への耐性、拒否の振る舞い、事実の正確さを、実際に配る重みで評価する。たとえば、自社の報告書で要約の正確さを14の言語で確かめる
- 提供の層: 利用者を識別する認証と認可、回数の制限、乱用の監視、入力と出力の検査を置く。社内と販売店の通信を分け、外向きの窓口は検査と回数の制限を厳しくし、用途も狭くする
さらに、入力と出力の検査を別のモデルで行うことが多いため、「評価する対象は、配るモデルと、検査するモデルの2つになる」と指摘しています。根拠となる資料を引かない窓口では、でたらめな数値(文書の例では、締め付けのトルクの値)も、正しい値と同じように読める点も、主なリスクとして挙げられています。
導入前に決めておくこと
文書の手順(範囲と基準の設定、評価、対策、監視)をもとに、中小規模の社内導入で先に決めておきたいことを、編集部として整理します。
- 入手したファイルを確かめる: 文書は「振る舞いより先に出どころを確かめる」とし、署名(OMS Model Signing など)で、受け取った重みが提供元の公開したものと同じかを確かめることを、評価では代えられない基本の統制としています。署名がなければ、未確認のリスクとして記録する
- 合格の基準を先に書く: 何をどれだけ間違えたら使わないかを、評価の前に決める。評価で測れるのは「試験の条件でその振る舞いが出る傾向」で、本番で起きる確からしさとは別物だと文書は注意しています
- 重みを変えたら評価し直す: 追加学習、量子化、モデルの統合で、性能は保ったまま安全の振る舞いだけが弱まることがある、と文書は書いています。量子化した版を配るなら、量子化した版で評価する
- 提供の層の統制を、自社のどこに置くか決める: 認証、回数の制限、入出力の検査、記録。プロンプトと出力の記録自体が、データ保護のリスクになる点も文書は挙げています
- 監視するものを決める: 派生版の公開、配布元の変更やライセンスの変更、新しい脱獄の手口、トークナイザーや実行基盤の脆弱性。重みの更新を待たずに対処できるよう、検査や制限を素早く変えられる形にしておく
モデルの取得経路を一か所に頼る危うさは、Hugging Face買収合意を機に、AIモデルの取得経路を見直すで扱いました。社内の端末へローカルの AI を配る方法は、Microsoft Foundry Local 入門が参考になります。外部の API に送るか、自社で動かすかを、データの置き場所から考える場合は、業務で使う生成AIに渡した情報は、どこの国のサーバーへ行くのかもあわせて読んでください。
確認した範囲
2026年10月29日に、GitHub の
NVIDIA/OpenEnterpriseRiskManagementGuidance(2026年10月28日のコミット16a16f4)を取得し、文書の PDF(版1.0.1、22ページ)、リスクの分類の PDF、README、変更履歴を読みました。あわせて、Microsoft Security Blog の紹介記事(2026年10月16日)を確認しました(資料調査)。文書の評価の手順やベンチマークは実行していません。上の「導入前に決めておくこと」は、文書の内容をもとにした編集部の整理です。
社内で動かす AI の構成や、評価と統制の設計は、開発・AI・自動化のご相談からお問い合わせください。