社内のコードや業務システムを AI エージェントに触らせたいものの、作業の記録(セッション履歴)を外部のサービスに預けることは社内の規程で認められない。Claude Managed Agents は、この壁で検討が止まりやすい製品でした。Anthropic が運用するサービスで、セッションの記録を Anthropic 側に保存するためです。
11月12日、Anthropic は Managed Agents のサーバーを自社の環境で動かす「セルフホスト版(self-hosted Claude Managed Agents)」をプライベートベータで公開しました。アカウントの担当者を通じて申し込む形で、誰でもすぐに試せるものではありません。本記事では、公式の告知とドキュメントから、何を自社で持つことになるのか、ネットワークの外へ何が出るのか、使えなくなる機能は何かを整理し、導入を検討する前に決めておくことを示します。
3つの運用の形
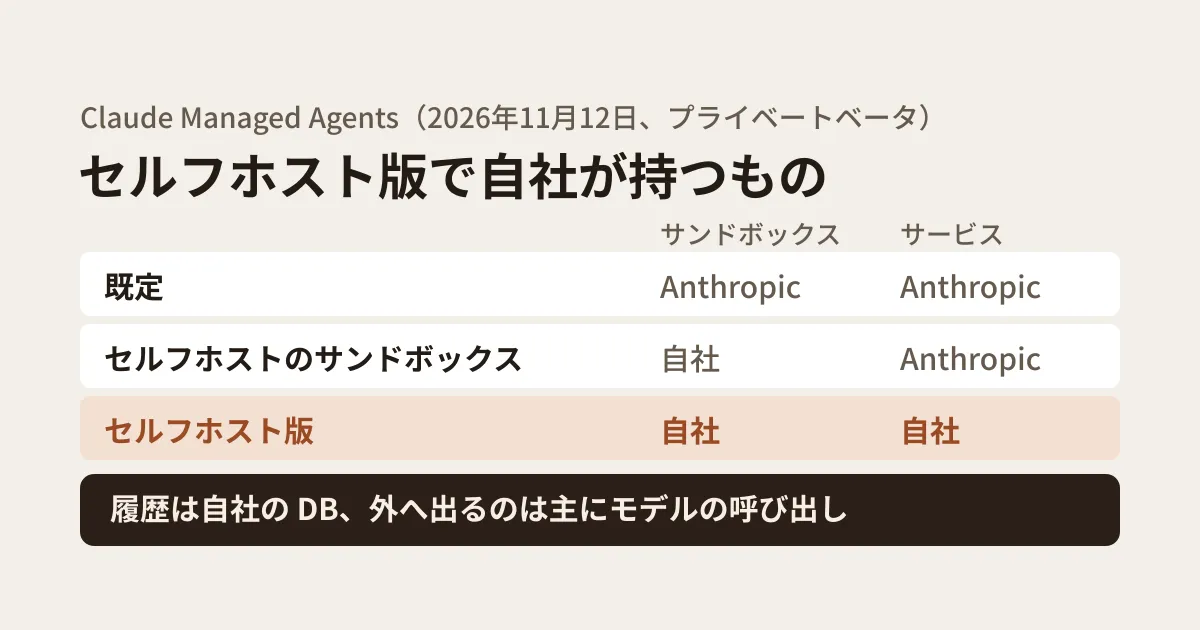
Managed Agents の構成要素は、エージェントのツール(シェルやファイル操作)が動く「サンドボックス」と、API・エージェントのループ・セッション履歴の保存を担う「サービス」に分かれます。ドキュメントは、誰がどちらを運用するかで3つの形を挙げています。
| 形 | サンドボックス | サービス | モデル |
|---|---|---|---|
| クラウドのサンドボックス(既定) | Anthropic | Anthropic | Anthropic |
| セルフホストのサンドボックス | 自社 | Anthropic | Anthropic |
| セルフホスト版(今回) | 自社 | 自社 | Anthropic か、自社が選ぶ提供元 |
ドキュメントがセルフホスト版を選ぶ理由として挙げるのは2つです。エージェント・セッション・履歴を自社で保存しなければならない場合と、モデルの呼び出し先を Amazon Bedrock、Google Cloud の Claude のモデル、Microsoft Foundry、自社のモデルのゲートウェイのいずれかにしなければならない場合です。ツールを自社の環境で動かしたいだけなら、Anthropic がサービスを運用するセルフホストのサンドボックスを使うよう案内しています。
ゼロデータリテンション(ZDR)との関係も書かれています。データの保持に関するページは、Managed Agents を ZDR の対象外としています。Anthropic がサービスを運用する形では、セッションの記録を削除するまで Anthropic が保存するためです。セルフホスト版では、その記録を保存するのは自社です。告知は、Anthropic と ZDR を結んでいる組織なら、Claude へ送るリクエストにもほかの Messages API の呼び出しと同じように ZDR が適用されるとしています。
自社で動かすもの
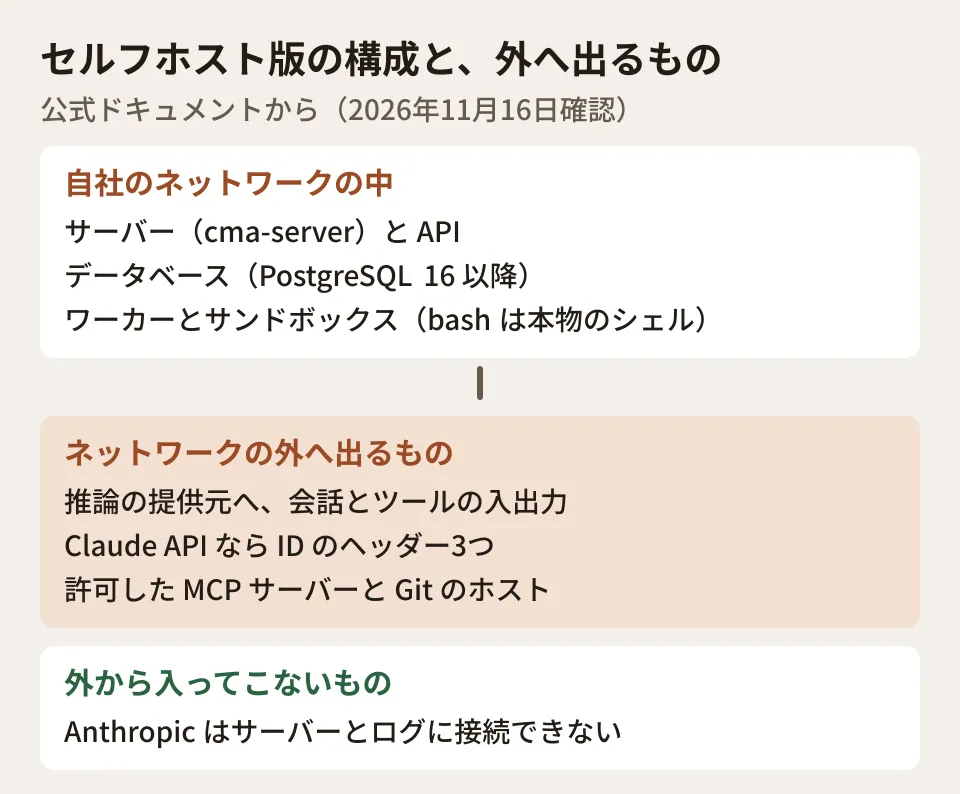
ドキュメントによると、1つの構成(デプロイメント)は次の要素からなります。
- サーバー(
cma-server): API を提供し、エージェントのループを回し、セッション履歴を保存する。エージェントのシェルやファイルのツールは実行しない。 - データベース: PostgreSQL 16 以降。設定しないとメモリーに保存し、再起動で消える。
- ワーカー: サーバーから仕事を受け取り、サンドボックスの中でシェルやファイルのツールを動かすプログラム。
- サーバー上のコンソール: 自社の ID プロバイダーでサインインして、エージェントの作成やセッションの実行ができる Web 画面。
- 管理用の CLI(
cma-server-admin): 環境と環境ごとの鍵を作る。
API は Anthropic が運用するサービスと同じで、SDK や ant CLI はそのまま自社のサーバーに向けられます。
1台の機械で試すための Docker Compose の構成も用意されています。ただしドキュメントは「開発用で、本番用ではない」としています。本番では、リリースに含まれる2つの Helm チャートで Kubernetes に載せることを勧めています。リリースごとの導入は自社で行います。
ネットワークの外へ出るもの
セキュリティの審査に答えるためのページ(Data and access)は、サーバーが接続する先を列挙しています。主なものは次のとおりです。
- 推論の提供元
- 自社のデータベース
- 許可した MCP サーバー
- 許可した Git のホスト
- 設定した場合の OpenTelemetry の収集先・ID プロバイダー・シークレットマネージャー
Anthropic に接続するのは、推論の提供元が Claude API の場合だけです。
モデルを呼び出すたびに、それまでの会話(プロンプト、ツールの入力と結果を含む)が推論の提供元に送られます。Claude API に送る場合は、セッション・エージェント・環境の ID を入れたヘッダーが付きます。ドキュメントは「ID に名前や内容は含まないが、作成した時刻は表す」とし、オフにする設定はないとしています。
ほかに、Claude API に送る場合について次の2点も書かれています。
- サーバーのソフトウェアの名前と版を示す
User-Agentが付く。 - 呼び出しに使う認証情報が有効かを、起動時と60秒ごとに Claude API へ確かめる(間隔は
health.check_intervalで変えられる)。この確かめでは推論をせず、上の ID のヘッダーも付かない。
このほか、モデルの呼び出しの本文に、どのサーバーでも同じ cma-server という目印(metadata.user_id)が入ることがあります。ドキュメントは、この目印や User-Agent で、Anthropic がセルフホスト版の利用を数えられるとしています。
逆方向については、「Anthropic はサーバーにもログにもリモートでアクセスできない」とあります。サーバーが受け付ける認証情報は、自社で作ったもの、自社の ID プロバイダーが発行したもの、サーバー自身が作ったもののいずれかです。
使えない機能と、設定するまで止まっている機能
Anthropic が運用するサービスとの違いをまとめたページ(Differences)から、業務での使い方に関わるものを抜き出します。
| 区分 | 主なもの |
|---|---|
| 使えない | Anthropic のクラウドの環境(自社のワーカーだけ)、Messages API・Files API(サーバーは提供しない)、mcp_oauth の認証情報、組み込みの docx・pdf・pptx・xlsx のスキル、スケジュール実行、Webhook |
| 設定するまで止まっている | MCP サーバー(許可したホストだけ)、Git のリポジトリ(許可したホストだけ)、web_search・web_fetch |
| 動きが違う | ワーカーがいなくてもモデルの処理は進み、最初のツールの呼び出しでエラーなしに待つ。URL で渡した画像・文書をモデルが見ないが、エラーにならない |
OAuth で更新するトークンが使えないため、MCP サーバーの認証は固定のトークンにして、期限の前に入れ替える運用になります。また、サーバーは強制プッシュを拒まないため、エージェントに渡すブランチは Git のホストの側で保護するよう書かれています。web_search・web_fetch は、設定で有効にしたあとも推論の提供元によって使えないことがあります。web_search は Claude API・Google Cloud・Microsoft Foundry、web_fetch は Claude API・Microsoft Foundry のときだけ動き、それ以外ではエラーにならずにモデルが呼び出せない状態になります。
自社が負うセキュリティの責任
ドキュメントの警告で最も重いのは、エージェントの bash ツールが「ワーカーのプロセスの権限とネットワークを持つ本物のシェル」で、ワーカー自体は隔離しないという点です。Compose の構成と Helm チャートは、セッションごとにワーカーを別のコンテナや Pod で起動します。自分でワーカーを起動する場合は、守るべきものを置いていない使い捨てのコンテナや VM で動かすよう求めています。
テナントの分け方も、Anthropic のサービスとは考え方が違います。1つの構成は1つのテナント・1つの信頼の水準だけを扱います。サーバーの API キーはすべての環境に届き、権限を持つ利用者は、どの環境でもセッションを実行できます。部署や取引先ごとに扱うデータの水準が違うなら、構成そのものを分けて、データベース・API キー・ワーカーを別々にします。
検討を始める前に決めること
ここからは編集部の整理です。
- 本当に必要なのはどの形か。 履歴の保存場所に社内の規程上の制約があるのか、モデルの呼び出し先を自社のクラウドに限りたいのか、ツールを社内のネットワークで動かしたいだけなのかを分けます。最後のものだけなら、サービスの運用を引き受けないセルフホストのサンドボックスで足ります。
- 誰が運用するか。 サーバー、PostgreSQL、Kubernetes、リリースごとの更新、ログと監視は自社の仕事になります。既存の基盤の担当に引き受ける余力があるかを先に確かめます。
- 使えない機能で困らないか。 組み込みの文書作成のスキル、スケジュール実行、Webhook に頼る設計なら、置き換えの方法を決めておきます。
- 信頼の水準をいくつに分けるか。 扱うデータの水準の数だけ構成が要るため、運用の負担はその数に比例します。
Managed Agents そのものの考え方はClaude Managed Agents の解説で、ホスト型での通信先の制限はweb_fetch の制限の記事で扱いました。
確認した範囲
2026年11月16日に、claude.com の告知(Operate Claude Managed Agents inside your security perimeter、2026年11月12日)と、platform.claude.com のドキュメント(Self-hosted Claude Managed Agents、Differences from the hosted service、Data and access、Inference provider、Get started)を確認しました(資料調査)。11月20日に、告知、5つのドキュメントの Markdown 版、Claude Platform のリリースノートを確かめ直しました。プライベートベータの利用権がないため、サーバーの入手・起動、Docker Compose の構成での試行、通信の観察は行っていません。セルフホスト版の料金、ベータを提供する国・地域、ベータの終了時期は、確認した資料に記載がありませんでした。
AI エージェントを社内のシステムに組み込むときの構成の選び方や、通信と権限の設計は、グリームハブの開発・AI・自動化のご相談で承っています。お問い合わせからご相談ください。
参考資料
- Claude — Operate Claude Managed Agents inside your security perimeter(2026-11-12)
- Claude Docs — Self-hosted Claude Managed Agents
- Claude Docs — Differences from the hosted service
- Claude Docs — Data and access in self-hosted Claude Managed Agents
- Claude Docs — Inference provider
- Claude Docs — Get started with self-hosted Claude Managed Agents