
「今期、どの商品が、どの得意先で伸びていますか」。この質問にチャットで答えてくれるなら、月次の集計作業はかなり減ります。実際、そういう機能が2026年9月に相次いで出ました。
AWS は9月10日、BIサービス Amazon Quick で、データ分析と表示を行うカスタムアプリケーションを自然言語の指示だけで構築できる機能を発表しました。アプリ構築の機能は9月1日から Plus / Professional / Enterprise の利用者に提供されています。同じ9月10日、OpenAI は ChatGPT Work に「Data agent」を追加しています。社内データに接続し、チャットのやり取りで分析を指示し、操作できるダッシュボードまで作れるものです。
接続できる先を見ると、両者ともよく似ています。Redshift、BigQuery、Snowflake、Databricks、MongoDB、ClickHouse、Salesforce、そして Google Drive や SharePoint 上のファイル。つまり、接続する先にデータが整って置かれていることが前提です。
導入して答えが出ない会社は、ここで詰まります。
詰まるのはツールではなくデータ側
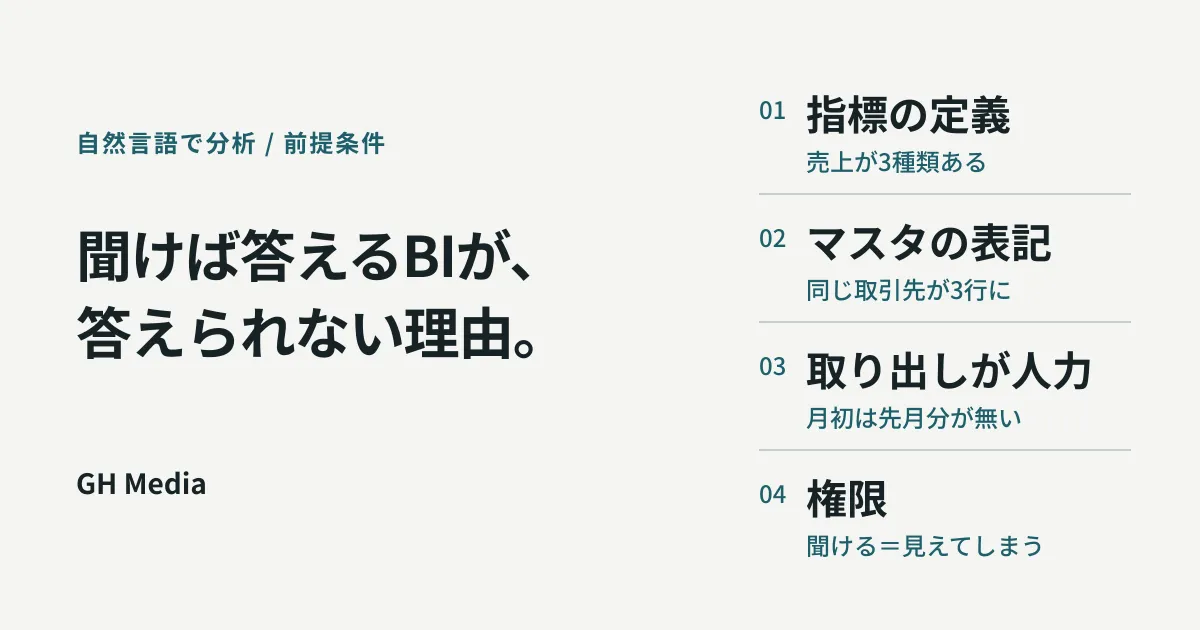
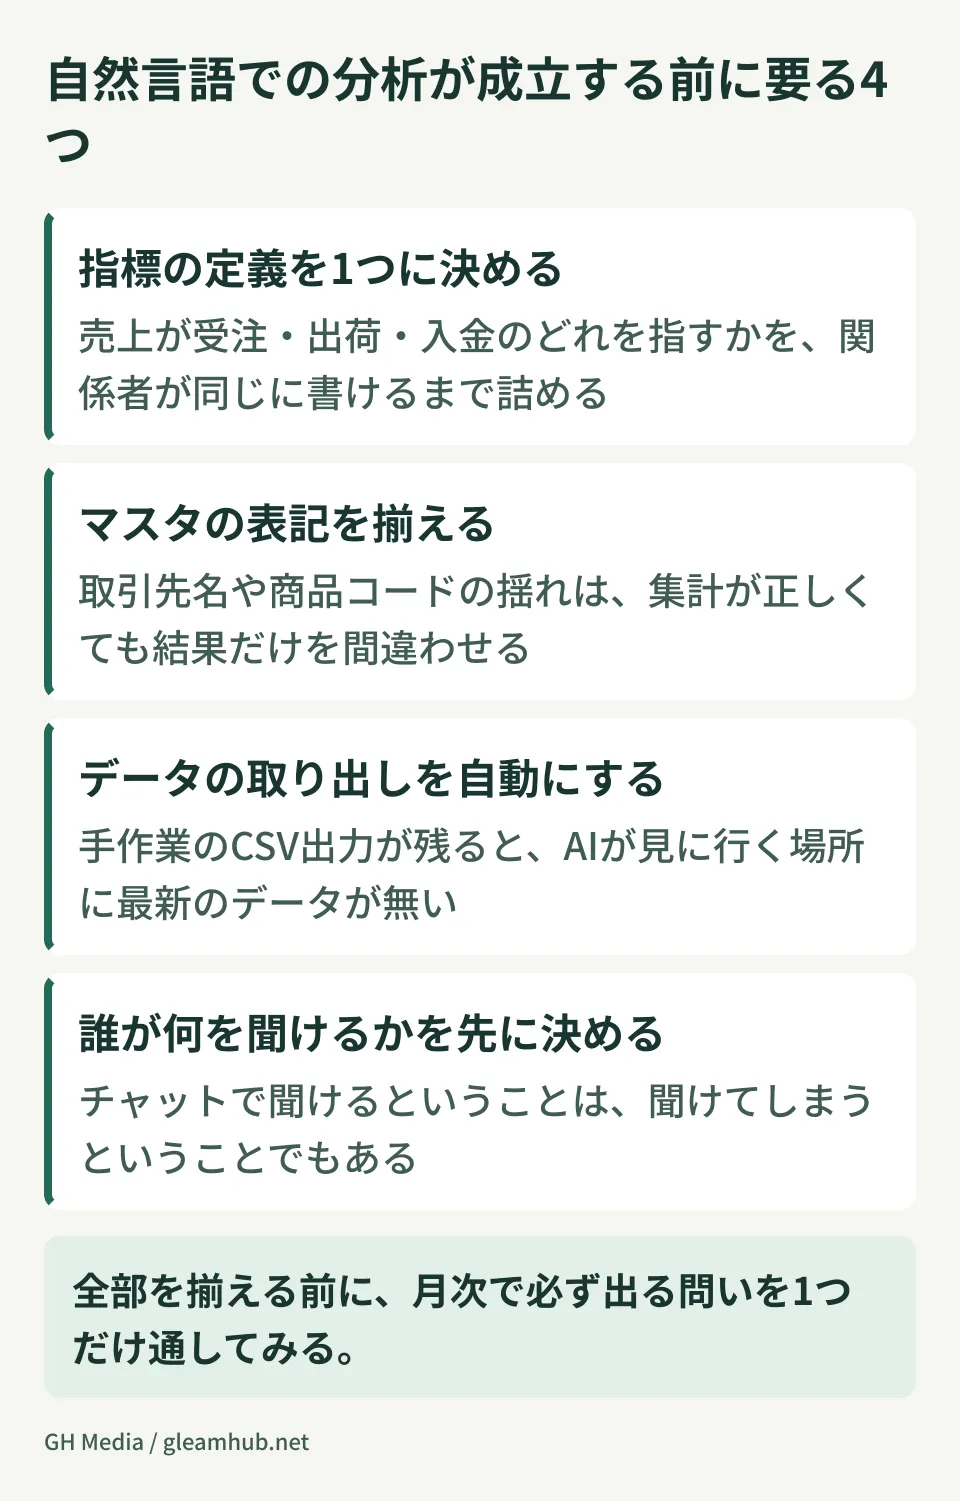
実際に中小企業で「自然言語で聞けるBI」を入れようとしたとき、止まる箇所はだいたい4つに分かれます。
1. 同じ言葉が、部署ごとに違うものを指している
「売上」が3種類ある会社は珍しくありません。受注ベース、出荷ベース、入金ベース。営業は受注で話し、経理は入金で話します。どちらも正しいのですが、AIに「今月の売上は」と聞くと、接続されたテーブルにある定義で答えます。答えが返ってきたあと、「その数字は何ベースか」を誰も確認しないまま会議資料になるのが、一番まずい形です。
ツールが賢くなっても、この曖昧さは解けません。定義を決めるのは業務側の仕事です。
2. マスタが揺れている
同じ取引先が「株式会社ABC」「(株)ABC」「ABC」で登録されている。商品コードが途中の年度で振り直されている。集計は正しく行われ、結果だけが間違うという、発見しにくい壊れ方をします。
自然言語の質問では、この壊れ方がさらに見えにくくなります。SQLを書いていれば「件数が合わない」と気づく場面でも、チャットの回答は自信を持った文章で返ってくるからです。マスタをどう揃えるかという論点は業務データの意味を揃える設計で扱った範囲そのものです。
3. データの取り出しが人力のまま
基幹システムから毎月CSVを手で落とし、Excelで加工して共有フォルダに置く。この運用が残っていると、AIが見に行ける場所に最新のデータがありません。月初の数日は先月のデータが無い、という状態になります。
接続先として指定できる形にするには、定期的な取り出しを自動化する必要があります。大がかりな基盤を作る話ではなく、まずはひとつのデータについて、決まった時刻に決まった場所へ置かれる状態を作ることです。
4. 権限を決めていない
全社の売上を誰でも聞けてよいのか。給与や原価はどうか。チャットで聞けるということは、聞けてしまうということでもあります。これまでは「その数字はシステムの権限がないと見られない」という物理的な壁が、実質的なルールを担っていました。分析の入口が一本化されると、その壁が消えます。
導入前に、データの種類ごとに「誰が聞けるか」を決めてください。後から絞るのは、一度見えたあとでは難しくなります。
接続先の一覧を見て、自社に何本あるか数える
両サービスが挙げている接続先をもう一度見てください。Redshift、BigQuery、Snowflake、Databricks、MongoDB、ClickHouse。データ基盤を持つ会社向けの名前が並びます。
社員数十人の会社で、この一覧に該当するものを持っているケースは多くありません。実際のデータの置き場所は、会計ソフト、販売管理システム、スプレッドシート、そして担当者のパソコンの中のExcelです。接続先の欄に入れるものが無い状態から始まります。
ただ、両サービスともファイルを直接扱える経路を持っています。Google Drive や SharePoint、OneDrive 上のファイル、S3 に置いたCSVやExcel。つまり、「決まった場所に、決まった形式で、決まった時刻に置く」だけでも入口にはなります。 データベースを新設するより、まずここを作るほうが早く、失敗しても捨てやすい。
スプレッドシートを共有の置き場として使う場合の限界と、そこを超えたときの選択肢は中小企業のデータの置き場所をどう選ぶかで整理しています。最初から本格的な基盤を選ぶ必要はありませんが、置き場所を1回決めたら、そこ以外に置かないという運用だけは最初から守ってください。置き場所が2つに増えた時点で、どちらが正しいかを人が判断する作業が戻ってきます。
何から手を付けるか
全部を揃えてから始めるのは現実的ではありません。ひとつの問いに絞って、その問いに答えられる状態だけを作るのが早いやり方です。
- 月次会議で必ず出る質問を1つ選ぶ。 「先月の商品別の粗利」など、毎回誰かが手作業で作っている数字がよい候補です
- その数字の定義を1枚に書く。 何ベースか、どの範囲を含むか、いつ時点か。関係者3人が同じ内容を書けるまで詰めます
- その数字に必要なデータだけを、定期的に置かれる状態にする。 全システムの連携は要りません
- その1問に答えられるかを試す。 答えられたら、次の問いを1つ足します
この順で進めると、途中でやめても手元に「定義が固まった数字がひとつ」残ります。基盤を先に作ってから使い道を探す進め方と比べて、失敗したときの損失が小さいのが利点です。
なお、ダッシュボードを作ること自体が目的化する失敗は、自然言語で作れるようになったことで増える可能性があります。作る前に決めるべきこととBIツールで何をどこまで見るかで整理した観点は、入力方法がチャットに変わっても効きます。「作れる」が簡単になるほど、「何のために見るか」の重みが増します。
次にやること
まず、直近の経営会議の資料を1枚開いて、そこに載っている数字がどこから来ているかを辿ってください。人がExcelで作っているなら、その工程がそのまま自動化の候補です。
そのうえで、その数字の定義を関係者に個別に聞いてみてください。答えが割れたら、ツールを入れる前に決めるべきことが見つかったということです。
社内データの整理と定義の棚卸し、基幹システムからのデータ取り出しの自動化、分析に使える形への整備については、グリームハブの開発・AI・自動化のご相談で承っています。使っているシステムとデータの持ち方によって進め方が変わるため、お問い合わせからご相談ください。


