社内データを扱うAI機能を作っていると、「集計の条件が毎回変わるので、その場でコードを書いて実行させたい」という要件が出てくることがあります。
ここで話が変わります。文章を生成するだけなら、外部のAPIを呼んで結果を返せば済みました。生成されたコードを実行するとなると、それを走らせる場所が要ります。しかも、実行するのは人が書いたコードではありません。
実行する場所を用意するというのは、何を用意することか
この手の機能で必要になるのは、次の性質を同時に満たす実行環境です。
- 実行中のコードが、他の利用者のデータや社内の別のシステムに届かないこと
- 要求が来てから実際にコードが動き出すまでが短いこと
- 使っていないときに費用が発生しないこと
- 無限ループや大量のメモリ確保で、他の処理を巻き込まないこと
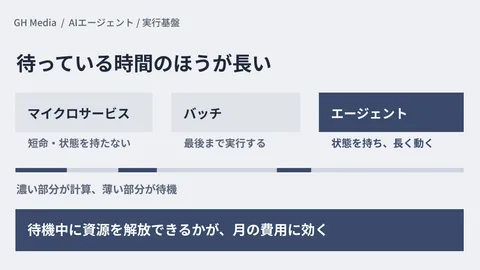
コンテナを1つ立てれば動くように見えますが、この4つを揃えようとすると、基盤の設計になります。待機時間の費用についてはエージェントは待っている時間が長いで扱いました。今回はその手前、そもそも自前で作るかどうかの線です。
極端まで行った例を1つ見ておく
サンドボックスなどを提供するModalの技術者、Colin Weld氏とConnor Adams氏が、2026年7月16日に同社のブログで、サンドボックスの基盤を作り直した記録を公開しました。InfoQが9月23日に報じています。
記録によると、同社はすでに1日に数百万個のサンドボックスを動かし、顧客1社あたり最大5万個の同時実行に対応していました。一方で強化学習では、数百万個を同時に動かし、始めに数十万個をまとめて作ることが求められる場合があります。既存の基盤はこの規模を想定して作られておらず、他の既存の仕組みも同じだ、というのが作り直しの出発点です。
同社は、従来のコンテナ基盤がこの規模で詰まる理由を、Kubernetesを例に説明しています。スケジューリングは最悪の場合でノード数とPod数の積に比例し、既定では1つずつ順に処理される。Podごとに、作られてから消えるまでに中央の永続ストアであるetcdへの書き込みが何度も起き、etcdは標準では1つのキー空間の中で分割できない。ノードが動いていることを知らせるだけでも、ノード数に比例した書き込みが続く。規模を上げることはできても、etcdの書き換えや置き換え、スケジューリングの並列化といった本格的な作業が要る、という説明です。
Modal自身はKubernetesの上に作っていませんが、元の基盤にも似た問題がありました。バックエンド全体で強い一貫性に頼っているため、サンドボックスを作って配置するたびに全体の調整が要り、サンドボックスの数に比例した書き込みが、簡単には分割できないPostgresに集まっていた、と書いています。
作り直しの方向は、この中央の調整をやめることでした。サンドボックスを作って動かす経路では全体の一貫性を手放し、並列に並べたスケジューリングのサーバー群が、メモリ上に持った状態から置き先のワーカーを選び、ワーカーへ直接RPCで作成を頼みます。ワーカーは空きがあれば受け、なければ断る。状態の正本は各ワーカーが自分で持ち、定期的にRedisのストリームへ流します。作成の経路にはデータストアを置かず、記録は主に後から非同期で書く、という構成です。
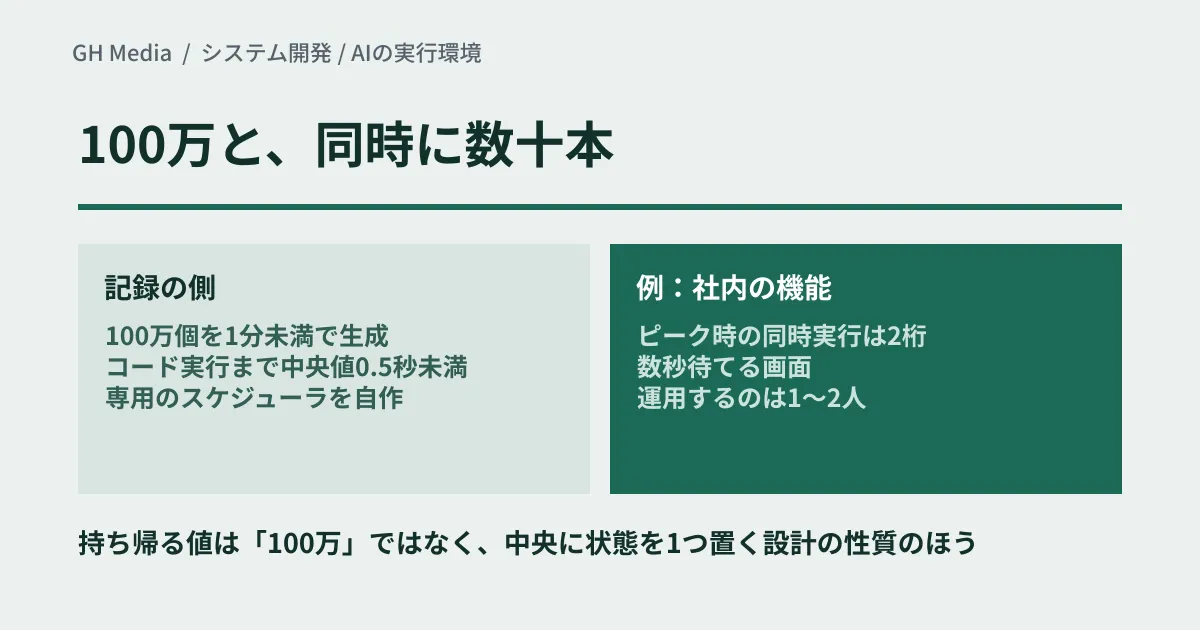
同社の計測では、100万個のサンドボックスを1分未満で作成でき(詰まりどころはベンチマークの側だったとしています)、作成を要求してから利用者のコードが動けるようになるまでの時間は中央値で0.5秒未満でした。遅いほうの裾は想定より長く、その多くは、同じワーカーで多数が同時に起動するときのカーネルとネットワークの競合によるものだとしています。最も差し迫った詰まりどころは、全ワーカーが状態を流す1本のRedisストリームで、負荷試験では10万ワーカーを大きく超えるまで持つ見込みだと説明されています。
新しい基盤は、7月の記事の時点ではベータでした。同社のPython SDKのリリースノートでは、8月12日の1.5.4から環境変数 MODAL_SANDBOX_V2=1 で選べるようになり、1.6.0で既定になる予定と書かれています(9月28日時点の最新は1.5.5)。
数字はいずれも提供側の計測で、編集部は再現していません。
読み取るべきなのは数字ではない
この記録から持ち帰る値は「100万」ではありません。中央に正しい状態を1つ置く設計では、サンドボックスやノードの数に比例する処理がそこに集まり、規模が上がるとそこが詰まりどころになるという、設計上の性質のほうです。
そして、その詰まりを外すために同社が費やしたのは、バックエンドの主なシステムの大半に及ぶ数か月の作業でした。スケジューリングのサーバー群、ワーカー側の状態管理、RPCの経路に加えて、サンドボックスの全機能と監視の作り直し、ワーカーの管理とコンテナの実行環境の変更まで含みます。大量のコンテナを一度に起動すると、ネットワークの設定でLinuxカーネルのロックを奪い合い、起動に数十秒かかる問題にも当たって、サンドボックスのネットワークの設定を変えています。これは実行基盤という製品を作る仕事であって、顧客の業務システムに付ける機能を作る仕事ではありません。
一方で、たとえば社内向けの機能で、ピーク時の同時実行が数十本だとします。Kubernetesの公式ドキュメントは1つのクラスターで5,000ノード・15万Podまでを想定しており、Modalの作り直し前の基盤も顧客1社あたり最大5万個の同時実行に対応していました。数十本は、どちらと比べても数百分の1以下です。この記録が扱った中央の調整の詰まりが、判断の中心になる規模ではありません。この規模で先に足りなくなりやすいのは、基盤を見る人の手のほうだ、というのが編集部の見立てです。
自前で作りたくなる理由と、その正体
それでも自前で組む案が出るときの理由として、次の3つが考えられます。いずれも最初は正しく聞こえます。
「外部のサービスに顧客のデータを流せない」。 これは本物の制約であり得ますが、実行環境そのものを自作する理由にはなりません。自社が管理するクラウドのアカウントやプロジェクトの中で動くマネージドの実行環境を使えば、境界の要件を満たせる場合があります。Google CloudのCloud Runのサンドボックス(9月28日時点でプレビュー)はAIが書いたコードを本番でそのまま動かして大丈夫かで、AWSのLambda MicroVMs(6月の告知で東京リージョンも対象)はLambdaで状態を持てない壁を越えるで扱いました。禁止されているのが「事業者に渡すこと」なのか「国外に出すこと」なのかで、選べるものが変わります。
「起動が遅いと使ってもらえない」。 Modalの新しい基盤で起動が速くなった主な理由は、スケジューリングが数十ミリ秒で済むようになったことだと同社は書いています。同時に多数を起動したときの遅いほうの裾は、同社もまだ縮めている途中です。起動の速さを理由に自作するなら、その速さを保つための作業(スケジューリングの経路、コンテナの起動、ネットワークの設定)も自社で持つことになります。先に決めるべきなのは、利用者が何秒待てるかです。
「将来の規模に備えたい」。 備えの対象が同時実行数なら、その規模が本当に来るかを先に見積もります。Modal自身も、求められる規模が変わった時点で、今ある基盤を育てるより一から作り直すほうが速いと判断しています。先に作ると、来なかった規模のための運用だけが残ります。
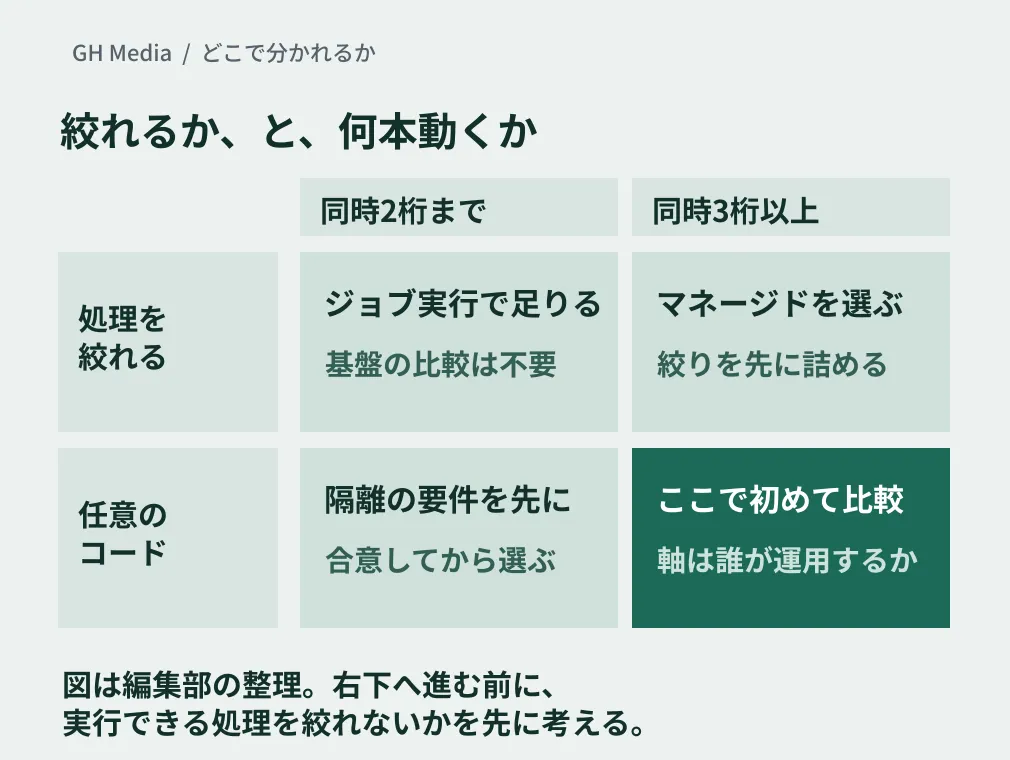
図の縦は実行するものを絞れるか、横は同時実行数です。左上(処理を絞れて、同時に2桁まで)から検討し、右下(任意のコードで、同時に3桁以上)に来たときに初めて基盤の比較に入ります。桁の区切りは編集部の目安です。
引くべき線
受託でAI機能に実行環境を組み込むとき、次の順で確かめると判断しやすくなります(編集部の整理で、公式の推奨ではありません)。
- 同時に何本動く見込みかを数字で置く。 ピーク時の同時実行数が2桁で収まるなら、同時実行数を理由に基盤を自作する必要は薄いと考えます。まず、マネージドのサンドボックスか、ジョブ実行のサービスで足りるかを確かめます。
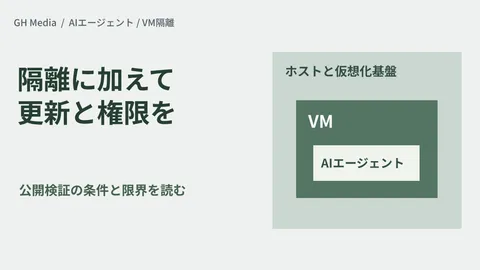
- 隔離の強さの要件を、顧客と言葉で合わせる。 「他社のデータが見えなければよい」のか「ホストのカーネルまで分けたい」のかで選択肢が変わります。VMによる隔離にも前提があることはVM隔離だけに頼らないに整理しました。
- 起動の速さを、体験の要件に翻訳する。 「中央値0.5秒」は魅力的な数字ですが、利用者が結果を待つ画面で数秒かかっても問題ない機能なら、その差に払う価値は小さくなります。
- 実行できることを絞れないかを先に考える。 任意のコードではなく、あらかじめ用意した処理の組み合わせに寄せられるなら、実行環境の要件は一段下がります。ここを詰めずに「何でも実行できる」前提で設計すると、あとから隔離の要件だけが積み上がります。
- 運用の担当を先に決める。 サンドボックスの基盤を1つ増やすと、監視・障害対応・更新の対象が1つ増えます。引き渡し後に誰が見るかが決まっていないなら、作らない側に倒すのが安全です。マネージド側の選択肢はGKEのAgent SandboxやCloudflare Sandboxesの記事にも整理しています。
次にやること
いま検討している機能について、ピーク時の同時実行数を1つの数字で書き出してください。桁が2桁で収まるなら、実行基盤の設計に時間を使うより、実行できる処理の範囲を絞る話し合いに時間を使うことを勧めます。
3桁以上になる見込みがあり、かつそれが継続するなら、そこで初めてマネージドの製品と自作を比べる意味が出てきます。比べるときの軸は、性能ではなく「誰が運用するか」です。
2026年9月28日に、Modalの技術ブログ(2026年7月16日付)、同社のPython SDKのリリースノート、Kubernetesの公式ドキュメント「Considerations for large clusters」(v1.37)、Cloud Runのサンドボックスの文書とLambda MicroVMsの告知を直接確認しました。InfoQの9月23日付の記事は報道として参照しています。100万個・1分未満・中央値0.5秒未満・10万ワーカーという数値はいずれも提供側の計測で、編集部は再現していません。Modalを含め、マネージドの実行環境は動かしておらず、起動の速さ・費用・隔離の強さは比べていません。同時実行数の桁による分け方と判断の5項目は編集部の整理です。
AI機能の実行環境の選定や、既存システムへの組み込みのご相談はグリームハブへ。
Sources
- Scaling to 1 million concurrent sandboxes in seconds — Modal Blog
- Python SDK Release Notes — Modal Docs
- Considerations for large clusters — Kubernetes Documentation
- Code execution in Cloud Run(Cloud Run sandboxes) — Google Cloud Documentation
- AWS introduces Lambda MicroVMs for isolated execution of user and AI-generated code — AWS What’s New
- 報道:Beyond Kubernetes at Modal: How to Scale 1 Million Concurrent Sandboxes in Seconds — InfoQ