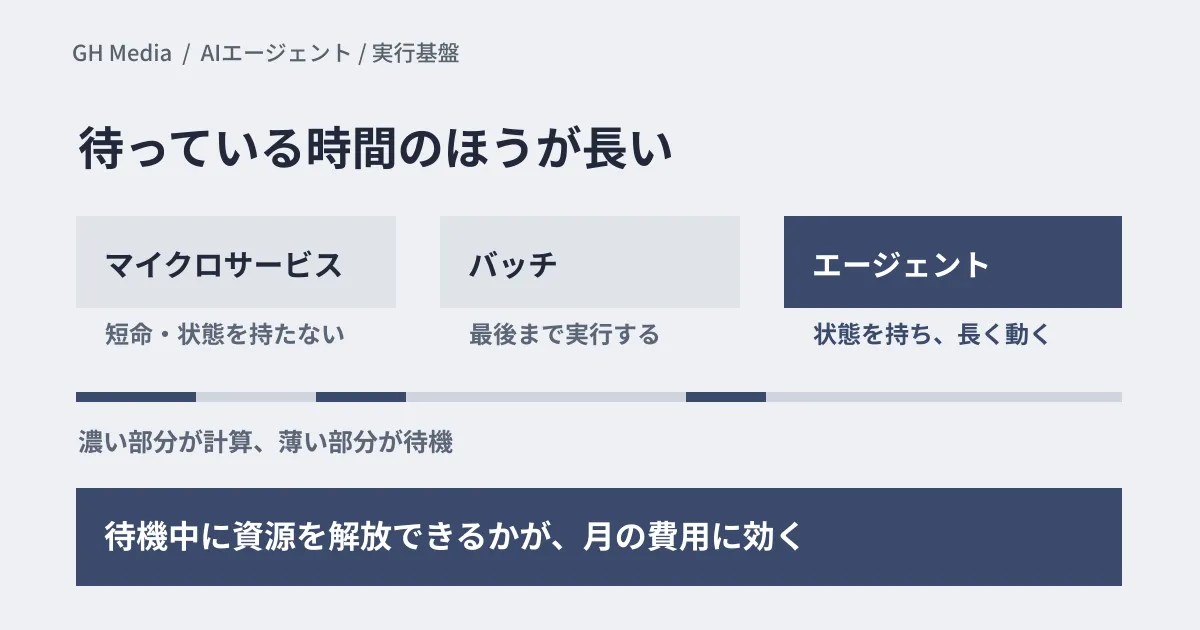
社内用のAIエージェントを常に起動したコンテナで動かす構成では、実際に処理している時間が短くても、実行環境の費用は起動している時間の分だけかかります。
原因は処理の形にあります。エージェントの仕事には、モデルの応答、外部APIの結果、人の承認を待つ時間が挟まります。Googleも、エージェントは短く集中して動いたあとに長い待機が続くことが多く、そのあいだ動かし続けると計算資源が無駄になると説明しています。待っているあいだCPUはほとんど使われませんが、常時起動の構成ではコンテナは確保されたままです。
前提の置き方が違う
Googleは2026年5月20日、エージェントの実行・再開・分散配置のためのオープンソースの実行基盤「Agent Executor」を、Google Cloudのブログで発表しました。GitHubのgoogleの組織にgoogle/axとして公開されており、コマンド名もaxです(以下、AX)。ライセンスはApache 2.0で、ブログはプレビューとして利用できるとしています。9月22日にはInfoQも報じました。
AXは、エージェントを作るためのフレームワークではありません。作ったエージェントをサンドボックスで動かし、作業環境を整え、数を増やして動かすための実行基盤です。Googleのブログは、特定のエージェントの枠組み(ハーネス)を問わないとしています。動かすには、Googleが同じ日に公開したAgent Substrateを入れたKubernetesクラスターが必要です。
READMEは、エージェントを「状態を持たないマイクロサービスでも、最後まで実行するバッチ処理でもない、新しい種類のワークロード」と位置づけています。公式サイトの説明はさらに具体的です。エージェントは状態を持ち、負荷が突発的で、長く動き続ける。しばらく集中して計算しては、モデルやツールの応答、人の承認を待つ。従来のオーケストレータでは、待機中のサンドボックスを動かし続けると費用がかさみ、1秒未満で止めて再開する仕組みも備わっていない、としています。
つまり、「待っている状態をどう安く保つか」を仕組みの中心に置いたものです。
止めて再開する仕組みの中身
READMEが挙げる基本の要素は3つです。CPUとメモリの上限を持つサンドボックスで処理を動かすTask、Gitリポジトリ・MCPサーバー・スキルを事前にそろえるWorkspace、使うモデルとその設定・認証情報をまとめるModelです。公式サイトは、通信先を許可リストで絞るGatewayを加えた4つを挙げていますが、9月26日時点のリポジトリの文書(README、Concepts、Manifests、API reference)にGatewayの説明はありませんでした。
待機に関わるのは、タスクの一時停止と再開です。リポジトリの文書から読み取れる現在の動きは次のとおりです。
ax suspendで状態を保存して止め、ax resumeで再開します。READMEは、アイドル状態のエージェントを止め、止めたところから再開する機能として説明しています。- 止まっているタスクにリクエストが届くと、Agent Substrateのルーターが先にタスクを再開してから転送します。
- ただし、一時停止で残るのは作業領域(
/workspace)のファイルです。再開すると新しいコンテナでプロセスが起動し直すため、再開に必要な状態は、止まる前にファイルへ書き出しておく必要があります。 - 待機を検知して自動で止める機能は、ロードマップに今後の項目として載っている段階です。
公式サイトは、待機中のエージェントを止め、1秒未満で戻せるとしています。編集部はAXを動かしておらず、この速さは確かめていません。止める操作は、当面はコマンドやAPIで行う前提で考えるのが安全です。
受託の観点で効くところ
自社や顧客のためにエージェントを組む立場で見ると、意味があるのは次の点です。
待機中の費用を設計の項目にできる。 常時起動しておくか、都度起動して立ち上がりの遅さを受け入れるか、という二択に、止めて必要なときに戻すという選択肢が加わります。前提は、エージェントが再開後に続きから動ける作りになっていることです。
人の承認を挟む処理を組みやすくなる。 承認待ちは長引くことがあります。Googleのブログも、長時間の実行には、障害や人の確認による中断のあとで再開できることが要ると説明しています。待っているあいだ資源を抱えずに済めば、承認フローを含むエージェントを組みやすくなります。承認をどこに置くかの設計は承認をコードの中に置くに整理しました。
ただし運用の担当が増える方向でもある。 READMEの前提条件は、Agent Substrateを入れたKubernetesクラスター、Goとkubectl、コンテナイメージを作るko、クラスターから取得できるコンテナレジストリです。制御面はRedisと一緒にクラスターに配置します。基盤を1つ増やせば、監視と障害対応の対象も1つ増えます。エージェントが1〜2本の規模なら、この運用の負担のほうが待機費用の節約より大きくなりやすい、というのが編集部の見立てです。
規模の数字は判断材料にしない
READMEと公式サイトは、1つのクラスターで数十億のタスクを動かせる設計だとしています。Agent SubstrateのREADMEも、標準的なコンテナの実行環境の10倍の密度や、500ミリ秒未満の再開をうたっています。いずれも提供側の説明で、編集部は計測していません。
判断に必要なのは規模の上限ではなく、自分たちの構成で待機時間がどれだけあるかです。ここは自社で測れます。
検討するかどうかの見分け方
導入を考える前に、次を確認すると判断しやすくなります。
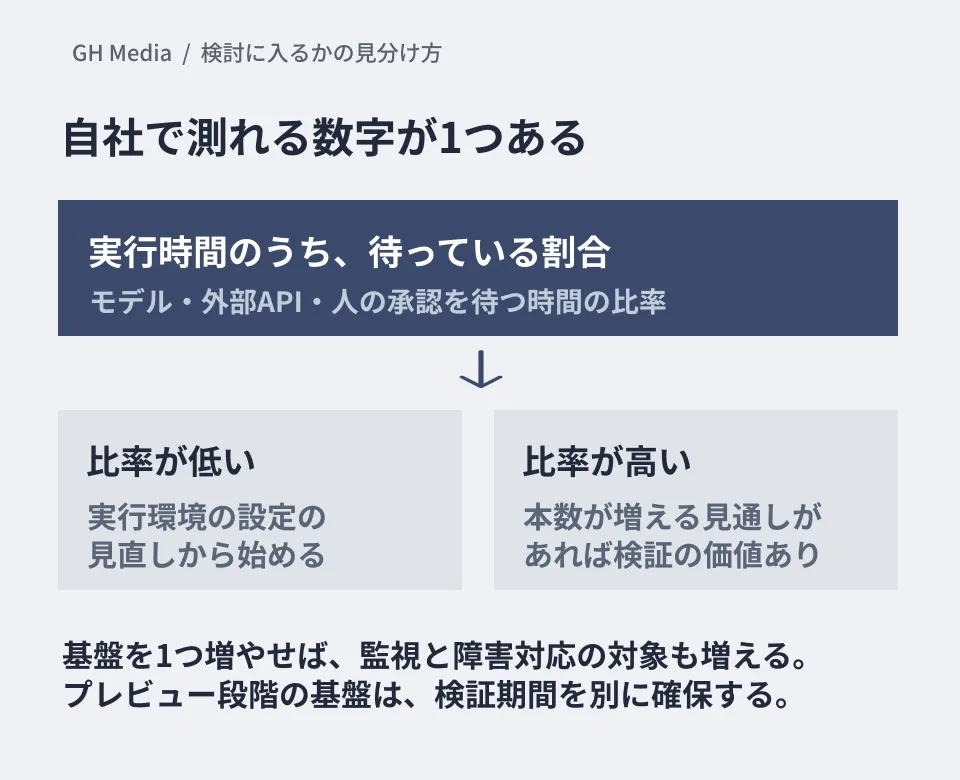
- いま動かしているエージェントの待機時間の比率を測る。 実行時間のうち、モデルや外部APIや人を待っている割合です。ここが小さければ、止めて再開する仕組みの恩恵は小さくなります。
- 同時に動くエージェントの本数を数える。 本数が少ないうちは、新しい基盤を足す前に、いまの実行環境で使っていない時間に止める設定や台数を減らす設定が使えないかを先に確かめてください。
- 待機の理由の内訳を見る。 人の承認待ちが大半なら、仕組みより承認フローの設計を見直すほうが効くことがあります。
- エージェントが再開後に続きから動けるかを確かめる。 AXの現在の仕組みでは、再開時にプロセスは起動し直し、作業領域のファイルが残ります。状態をメモリだけに持つ作りなら、手直しが要ります。
- プレビュー段階であることを計画に入れる。 READMEは、安定版までに大きな破壊的変更が入る見込みだと明記しています。Agent Substrateも1.0前で、後方互換を保証していません。顧客の本番に入れる判断は、検証の期間を別に確保できる場合に限ったほうが安全です。
エージェントの作業手順そのもの(どの工程を任せ、どこで人に戻すか)の設計は、実行基盤とは別の層の話です。複数のエージェントを組み合わせる構成の設計はエージェントオーケストレーションの設計にまとめています。
次にやること
動かしているエージェントがあるなら、1週間分のログから待機時間の比率を出してください。この数字が、今回の話題が自社に関係するかどうかを見分ける最初の材料になります。
比率が高く、かつ本数が増える見通しがあるなら、検証環境で試す価値があります。そうでなければ、いまは実行環境の設定の見直しが先です。
2026年9月26日に、Google Cloudのブログ2本(Agent ExecutorとAgent Substrateの発表、いずれも2026年5月20日付)、AXの公式サイト(agentexecutor.io)、GitHubのgoogle/axのREADME・各文書(Concepts、Manifests、Runners、Networking、Roadmap、Architecture)・ライセンス、Agent SubstrateのREADMEとArchitectureの文書を確認しました。AXのインストールと実行、一時停止と再開の速さ、費用の比較は行っていません。規模や再開の速さに関する提供側の数値と、公式サイトにだけ載っているGatewayの仕様は確かめられていないため、判断材料に使っていません。InfoQの2026年9月22日付の記事は報道として参照しました。
社内向けAIエージェントの構成設計や、待機時間を含めた費用の試算は、グリームハブへご相談ください。
Sources
- Introducing Agent Executor, Google’s distributed Agent Runtime — Google Cloud Blog
- Agent Sandbox on GKE is now available for everyone, and a first look at Agent Substrate — Google Cloud Blog
- AX — 公式サイト
- google/ax — GitHub
- Runners — google/ax
- Networking — google/ax
- Roadmap — google/ax
- agent-substrate/substrate — GitHub
- 報道:Google Open-Sources AX a Kubernetes Style Orchestrator for Autonomous AI Agents — InfoQ