
受注データの取り込み、請求書の生成、在庫の同期、月次レポートの配信。業務の自動処理は、たいてい1本ずつ増えていきます。最初はcronに1行足すだけで済みます。5本目あたりから、AがBの完了を待つ、Bが失敗したらCは動かさない、といった依存関係が出てきます。10本を超えたころ、失敗したときにどこから再実行すればいいかを知っている人が1人しかいない状態になります。
この段階で「ワークフロー基盤を入れるべきか」という話が出ます。ただ、この問いは規模によって答えが真逆になるため、他社の事例をそのまま持ってきても判断材料になりません。
2026年9月、Netflixが自社のワークフローオーケストレーション基盤Conductorを作り直した内容を公開しました。桁違いの規模の話ですが、どこが壊れたから作り直したのかを見ると、規模の小さい現場で起きていることと同じ構造が見えます。
Netflixが直した3か所
現在のConductorは、150のアプリケーションにまたがる約20万のワークフロー定義を抱え、月あたり約4.2億のワークフローを実行しています。今回の作り直しで、1つのワークフローが扱えるタスク数を約2,500から30,000へ引き上げ、ワークフロー評価のp99レイテンシを約40%削減しました。
内部で変えたのは主に3か所です。実行データの保管先をDynomiteからCassandraへ移し、サイズの大きなタスクの入出力をAmazon S3へ追い出し、キューの仕組みをDynoQueuesからTimestoneへ置き換えています。
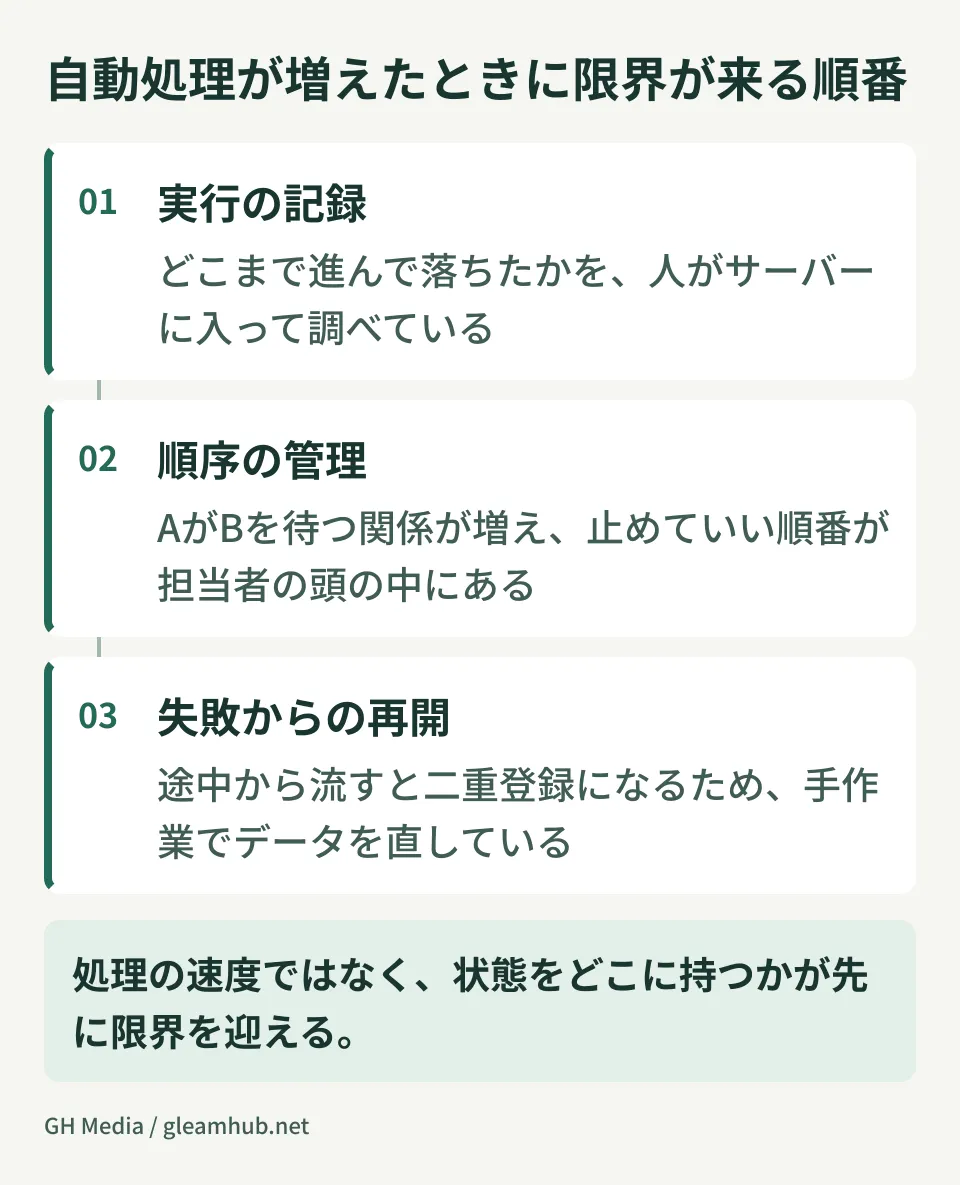
注目したいのは、3つとも「処理そのもの」ではなく「処理を記録し、順番を管理する部分」の作り直しだという点です。ワークフローが増えて困るのは、個々の処理が重いからではありません。実行の状態をどこに持ち、何を待たせ、失敗をどう記録するかという周辺部分が先に音を上げます。これは月4.2億実行でも、日次10本でも同じ順番で起こります。
小さい現場で先に壊れるのは記録のほう
日次バッチが10本ある会社で、実際に人が困る場面を並べてみます。
夜間の処理が失敗していたことに、翌朝10時に営業から「データが古い」と言われて気づく。どこまで進んで落ちたかを調べるためにサーバーへ入ってログを追う。途中から再実行していいのか、最初からやり直すと二重登録になるのかが分からず、結局手作業でデータを直す。
このどれも、処理の速度とは関係ありません。実行の状態が見える形で残っていないことと、途中から再開できる設計になっていないことが原因です。Netflixが作り直した3か所と、困っている場所は同じです。規模が違うのは、それが顕在化するまでの本数だけです。
基盤を持つ前に通れる段階がある
ここで多いのが、いきなりワークフローエンジンの選定に入ってしまうことです。OSSのエンジンを立てると、それ自体が運用対象になります。バージョン追随、障害時の切り分け、権限管理。自動化のために増やした仕組みが、新しい運用業務を生むという交換が発生します。
判断の前に、今どの段階にいるかを確かめるほうが先です。
| 段階 | 症状 | 妥当な打ち手 |
|---|---|---|
| 処理が数本、依存なし | たまに失敗するが手で直せる | cronとログ通知で足りる |
| 依存関係が出てきた | 順番待ちと再実行の判断が属人化 | 実行ログの集約と再実行手順の文書化 |
| 十数本、担当が複数 | 誰が何を止めたか分からない | マネージドのワークフローサービス |
| 業務の中核が乗っている | 止まると売上が止まる | 基盤として設計し、運用体制を付ける |
多くの中小企業は、上から2番目か3番目の段階で止まります。ここでフルスクラッチの基盤を作ると、作った人以外が触れないものが1つ増えるだけになりがちです。クラウド各社のマネージドなワークフローサービスや、既存のSaaSが持つ自動化機能で足りる範囲は思ったより広いです。
逆に、4番目の段階に来ているのに2番目の道具で回している場合は、手作業の復旧が常態化します。この見極めを、動いている本数ではなく止まったときに何分で誰が気づくかで測ると、実態に近い判断ができます。
既製品で足りるかどうかの線引きは、kintoneで作れる範囲と作れない範囲や予約システムは作るか借りるかでも、別の題材で同じ構造を扱っています。
作る側に回るなら決めておくこと
基盤を持つと決めた場合、設計で先に決まっていないと後から効いてくる項目があります。
途中から再開できる単位をどこに置くか。 1つのワークフローを大きく作るほど、失敗時にやり直す範囲が広くなります。Netflixが1ワークフローあたり30,000タスクまで扱えるようにしたのは、大きく作れるようにするためであって、大きく作るべきだという話ではありません。自社では、業務として意味のある区切りでタスクを分けておくと、再実行の判断が人間の言葉でできます。
入出力のデータをどこに置くか。 大きなファイルやレコードの中身をワークフローの状態に含めると、記録側がすぐ膨らみます。実体は別の場所に置き、ワークフローは場所を指すだけにする。Netflixが大きなタスク入出力をS3へ移したのと同じ考え方で、規模に関係なく最初から効きます。
誰が夜中に起きるか。 これが一番よく抜けます。基盤を入れると通知は出るようになりますが、通知を受けて対応する人を決めていなければ、朝まで誰も見ません。運用体制まで含めて設計しないと、可視化しただけで終わります。この種の見えにくいコストはAIエージェント基盤を自前で持つときの見えないコストでも扱っています。
次にやること
自社で動いている自動処理を、本数ではなく依存関係の図として書き出してみてください。矢印が交差し始めていたら、cronで管理できる範囲は超えています。
そのうえで、直近3か月で「手作業でデータを直した」回数を数えてください。月に数回あるなら、道具を足す前に、再実行できる単位の設計を見直すほうが先です。
グリームハブでは、業務処理の自動化基盤の設計・開発のご相談を承っています。既製のサービスで足りる範囲と、作らないと届かない範囲の切り分けからお手伝いできます。要件によって最適な構成は変わるため、まずは個別にお見積りいたします。お問い合わせからご相談ください。




