社内チャットのAIエージェントに「先月の受注で、入金がまだの取引先は?」と聞けば答えが返ってくる。そのためには、受注や請求を管理している本番のデータベースをエージェントに読ませる必要があります。気になるのは、エージェントが投げる問い合わせで基幹システムが遅くならないか、意図しない更新や持ち出しが起きないか、という点です。
Google Cloudは2026年9月24日の公式ブログで、AlloyDB for PostgreSQLに「PostgreSQL for agents」をプレビューとして追加したと公表しました。エージェントの読み取りを、本番の業務処理とは別の計算資源で受け止める仕組みです。公式ブログで確認できた内容と未確認の点を分け、AlloyDBを使っていない場合にも先に決めておく設計を整理します。
エージェントの読み取りは、人の画面操作と負荷の形が違う
業務アプリの画面が発行するSQLは開発時に決めた形に限られますが、エージェントは質問に応じてSQLを組み立て、結果を見て問い合わせを重ねます。
同日公開の技術解説「A new, no-compromises database architecture for the agentic era」は、エージェントの処理について「Agentic workloads are generated dynamically and cannot be vetted in advance」(その場で生成され、事前に検証できない)と書き、本番から切り離すことを事業継続上の必須条件としています。発表記事も、少数のエージェントが推論を繰り返すだけで問い合わせが急増し、従来の構成では処理しきれなくなりうると説明しています。
ここからは編集部の整理です。エージェントに本番データを読ませる設計では、次の2つを分けて考えると判断しやすくなります。
- 負荷の問題:重い集計や想定外の全件走査が、受注登録などの業務処理と同じ計算資源を奪い合わないか
- 安全の問題:更新・削除ができない状態か、見せてよい列だけか、誰の依頼で何を読んだか追えるか
AlloyDBの新機能が主に答えようとしているのは前者です。後者は、どの方式を選んでも利用者側で設計する部分が残ります。
Googleが説明する「PostgreSQL for agents」
発表記事と技術解説から、確認できた内容を並べます。いずれも2026年10月2日時点でプレビューです。ドキュメントのページによると、使うにはプレビューへの参加を申し込む必要があります(10月5日に確認)。
- 本番から切り離した読み取り専用の実行環境。 エージェント用に数秒でサンドボックス化したインスタンスを用意し、本番データへ「up-to-the-second read-only access」(秒単位で新しい読み取り専用アクセス)を持たせます。プライマリ、スタンバイ、リードレプリカといった本番系のインスタンスとは完全に分離されていると説明しています
- ストレージは共有、計算資源は別。 各インスタンスはGoogleの分散ストレージColossus上の共通のストレージ層からデータを読みます。技術解説によると、エージェント用のノードはmicroVMで動き、本番とは別のColossusのセグメントから読みます。標語は「Share the data. Share nothing else.」です
- PostgreSQLの機能をそのまま使える。 全インデックス、SQL、ベクトル検索・全文検索・空間検索が使えるとしています
- 使い終わると0台に戻る。 エージェントの処理が終わるとインスタンスは自動で停止し、従量課金になります。技術解説は、課金がノードの稼働秒単位だと説明しています
- BigQueryやSparkとの横断クエリ。 ETLの仕組みを作らずに、レイクハウス側のデータと突き合わせられるとしています
- 接続はMCP経由。 技術解説は、エージェントがModel Context Protocol(MCP)でエージェント用のノード群につながると書いています
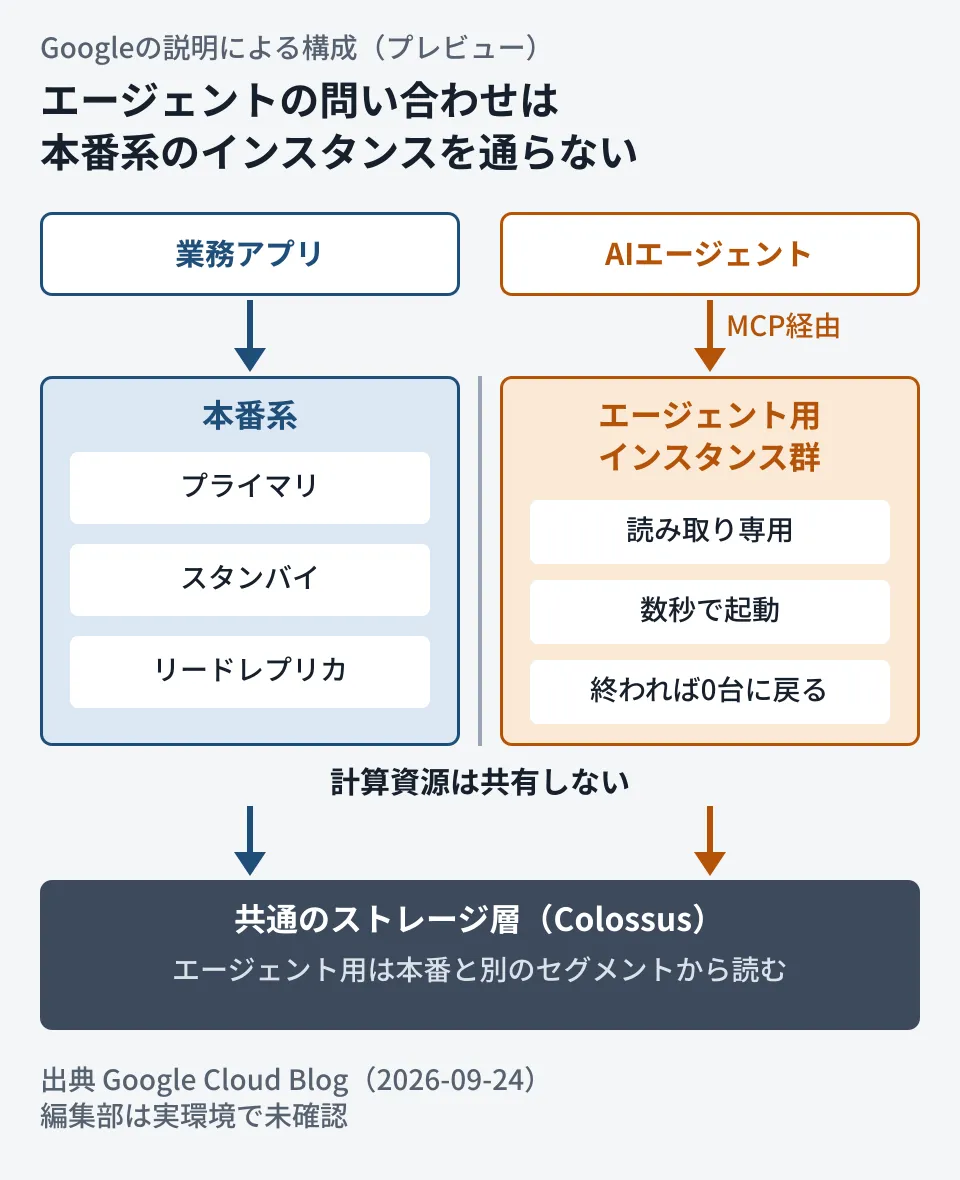
両者が共有するのはストレージ層のデータだけで、エージェントの問い合わせは本番系のインスタンスを通りません。Googleの説明を図にしたもので、編集部は実環境で確かめていません。
性能について、技術解説はGoogle自身の試験結果を載せています。エージェント用ノードを1台から1,000台まで増やしても、プライマリの性能に「no measurable impact」(測定できる影響なし)だったこと、合計のスループットが毎秒300万クエリに達したこと、2,100ノードの全件走査で合計の読み取りが毎秒1テラビットを超えたことです。発表記事も「sub-millisecond I/O」(1ミリ秒未満のI/O)をうたっています。いずれもGoogleの発表値で、編集部は測定していません。
セキュリティ面では、発表記事がAlloyDB全体の特徴としてIAM認証、VPC Service Controls、顧客管理の暗号鍵(CMEK)、監査を挙げています。これらがエージェント用インスタンスにどこまで同じ形で適用されるかは、ドキュメントで確認できていません。
読み取り先の選択肢を並べる
本番データをエージェントに読ませる場所は、大きく3つに分けられます。下の表は公式ブログの説明と、一般的な構成についての編集部の整理を合わせたものです。
| 読み取り先 | データの新しさ | 本番への影響 | 費用の形 |
|---|---|---|---|
| 本番DBのリードレプリカ | 複製の遅れの分だけ古い | 計算資源は分かれるが、構成によりストレージや複製経路を共有 | 常時稼働の台数分 |
| 分析用のコピー(ETL・DWH) | 取り込みの間隔分だけ古い | 取り込み時以外はほぼ切り離せる | 取り込み基盤と分析基盤の費用 |
| AlloyDB PostgreSQL for agents(プレビュー) | 秒単位(Googleの説明) | 本番系と計算資源を共有しない(Googleの説明) | 稼働秒単位の従量課金(単価は未確認) |
技術解説は、独立したリードレプリカについて、本番と切り離せて応答も速い一方、台数を増やすたびに大量のデータを複製するため数時間かかり、エージェントの短い急増に合わないと評価しています。待機中も費用がかかる点も挙げています。
編集部の整理では、問い合わせの量が読める社内向けエージェントなら、既存のリードレプリカや分析用のコピーで足りる場面もあります。AlloyDBの新機能が効いてくるのは、エージェントの数や問い合わせが急に増える場合と、数秒前のデータまで必要な業務です。
まだ分からないこと
2026年10月2日時点で、公式ブログからは次の点を確認できませんでした。発表記事が案内しているドキュメントのページ(9月30日更新)も10月5日に開きましたが、載っていたのは概要とプレビューへの参加申請の案内だけで、次の点は書かれていませんでした。
- 料金。 従量課金で稼働秒単位という説明はありますが、単価は載っていません
- 一般提供(GA)の時期。 発表記事は「now available in preview」とだけ書いています
- 上限と制約。 1つのデータベースで同時に動かせる台数、1回の問い合わせの時間制限、起動にかかる秒数の条件などは、技術解説の試験値以外に示されていません
- 提供リージョン。 東京・大阪で使えるかは未確認です
- 書き込み。 説明は一貫して読み取り専用です。将来書き込みに対応するかは書かれていません
- 前提となる構成。 AlloyDBの機能なので、Cloud SQLや他社クラウド、オンプレミスのPostgreSQLでは使えない前提で考える必要があります
プレビューの段階の機能は、GAまでに提供条件や仕様が変わる可能性があります。本番の業務に組み込む前に、利用規約とドキュメントで条件を確かめてください。
どの方式でも先に決めること(編集部の提案)
エージェント専用の読み取りロールを作る
アプリと同じ接続ユーザーを使い回すと、エージェントにも更新権限が渡ります。プロンプトでの「参照だけ」の指示は制限になりません。PostgreSQLなら参照だけを許すロールを別に作ります。
create role agent_ro login password '...';
grant usage on schema public to agent_ro;
grant select on orders to agent_ro;              -- 見せる表だけ
alter role agent_ro set default_transaction_read_only = on;
alter role agent_ro set statement_timeout = '30s';
編集部はこの考え方を、WebAssembly版のPostgreSQLであるPGlite(0.5.8、PostgreSQL 18.3)で確かめました。AlloyDBではなく、一般的なPostgreSQLの権限の動きの確認です。agent_ro に切り替えると、select count(*) from orders は1,000件を返し、insert と delete は「permission denied for table orders」、create table は「permission denied for schema public」で拒否されました。所有者のまま default_transaction_read_only = on にした接続でも、insert は「cannot execute INSERT in a read-only transaction」で止まりました。
一方、statement_timeout = '1s' を設定しても、PGliteでは3秒の pg_sleep も10億行の集計も最後まで実行されました。WebAssembly版の制約と見られ、この環境では確かめられていません。実際のデータベースで止まることを確認してください。
見せる範囲を表や列の単位で絞る
個人情報や原価のように、エージェント経由で答えさせたくない列は、ビューを作ってそのビューだけに権限を与えます。読み取り専用でも、読んだ内容は会話を通じて社内に広がります。更新を許す段階の考え方はAIエージェントに更新を許すときの境界の記事で整理しました。
計算資源と時間に上限を置く
業務処理と同じインスタンスにつなぐなら、問い合わせの制限時間、同時接続数、返す行数の上限を決めます。リードレプリカや分析用のコピー、AlloyDBのエージェント用インスタンスのように、本番と別の計算資源へつなげるなら、上限は緩めにできます。AlloyDBのスタンバイ構成はAlloyDBホットスタンバイの記事でも扱いました。
誰の依頼で何を読んだかを残す
エージェントが発行したSQLと、その元になった利用者の依頼を結び付けて記録します。データベース側の監査ログだけでは、どの社員の質問だったかが分からないことがあります。エージェントが本番を壊した事例と対策は本番DBの削除事故とガードレールの記事にまとめています。
プレビューは検証環境から試す
AlloyDBで新機能を試すなら、まず検証用のクラスタで起動にかかる時間、費用の出方、監査ログの残り方を確かめます。プレビューのまま基幹業務の判断に組み込むのは、GAと料金の公表を待ってからが無難です。
2026年10月2日に、Google Cloud公式ブログの発表記事「AlloyDB delivers PostgreSQL for agents: Real-time data at agent scale, with full workload isolation」と技術解説「A new, no-compromises database architecture for the agentic era」(いずれも2026年9月24日付)を直接開いて確認しました。性能の数値はGoogleの発表値で、編集部は測定していません。AlloyDBのドキュメントのページは公開前の10月5日に開きましたが、概要とプレビューへの参加申請の案内だけで、料金・上限・リージョンは未確認です。読み取りロールと読み取り専用の設定は、PGlite 0.5.8(PostgreSQL 18.3、Node.js v22.22.0、Linux)で1回ずつ確認したもので、AlloyDBでの動作ではありません。
statement_timeoutはPGliteでは効かず、確認できていません。
社内データをAIエージェントにつなぐ設計や、データベースの権限・構成の見直しなど、開発・AI・自動化のご相談はグリームハブへお問い合わせください。
Sources
- AlloyDB delivers PostgreSQL for agents: Real-time data at agent scale, with full workload isolation — Google Cloud Blog
- A new, no-compromises database architecture for the agentic era — Google Cloud Blog
- PostgreSQL for agents in AlloyDB — AlloyDB for PostgreSQL ドキュメント
- PGlite (@electric-sql/pglite) — npm