GA4のデータをBigQueryへエクスポートしている。売上や在庫の表もBigQueryにある。分析担当がClaude Codeに「先月の流入元別のCVRを出して」と頼むと、エージェントはテーブルの構成を知らないため、スキーマやエラーをチャットに貼り付けて補うことになります。
Google Cloudが2026年9月30日に正式版(GA)にしたData Agent Kitは、この隙間を埋める道具です。エージェントがスキーマを調べ、クエリを実行し、ジョブのログを読めるようになります。その代わり、エージェントはあなたのIAM権限でBigQueryを操作します。何がつながり、どこで止められるのかを、公式ブログ、公開リポジトリ、編集部が取得したツール一覧から整理します。
Data Agent Kitは「MCPのツール」と「スキル」の組み合わせ
公式ブログによると、Data Agent Kitは「free set of Model Context Protocol (MCP) tools and agent skills」です。中身は2つです。
- MCPのツール: 15を超えるGoogle Data Cloudのサービスにつなぎ、エージェントがスキーマの確認、クエリの実行、ジョブのログの読み取り、リソースの管理を行えるようにする
- Googleが書いたスキル: BigQueryのSQLの最適化、Bigtableの行キーの設計、dbtのパイプライン作りなどの手順を、エージェント向けの指示としてまとめたもの。GitHubでオープンソースとして公開されている
使える場所は、VS Code互換のエディタ(VS Code、Antigravity IDE、Cursorなど)の拡張機能、Antigravity 2.0・Antigravity CLI・Claude Code・Codexのプラグイン、最初から入っているCloud ShellとCloud Workstationsです。GAでは、BigQuery Graph、Bigtable、Managed Service for Apache Spark への対応が加わりました。
料金について、製品ページは「available at no charge for users with Google Cloud accounts」としています。ただし公式ブログのとおり、エージェントが使ったGoogle Cloudのサービスの通常料金はかかります。
READMEによると、プラグインはAgent Plugins準拠のクライアントにも対応しています。
BigQueryに対して、エージェントは何ができるのか
Claude Code向けのプラグイン設定(.claude-plugin/mcp.json)を読むと、BigQueryへの接続先は https://bigquery.googleapis.com/mcp です。手元の中継プログラムを通して、GoogleのMCPのエンドポイントへつなぐ構成です。
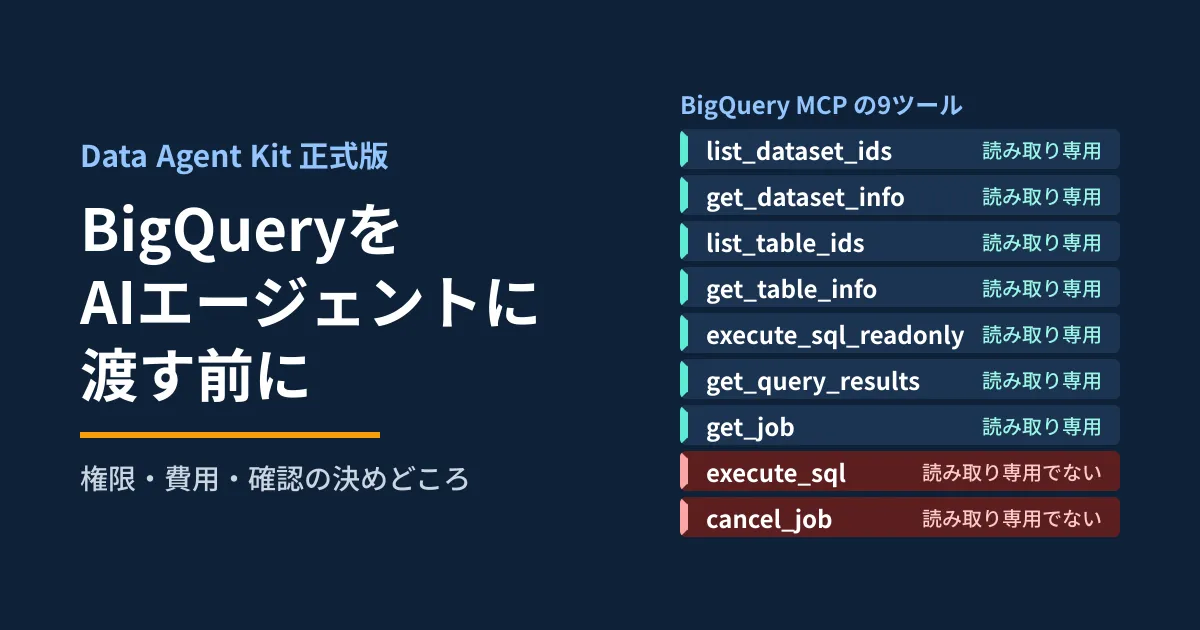
編集部は2026年10月2日に、このURLへMCPのツール一覧の要求(tools/list)を認証なしで送りました。返ってきたツールは9つです。各ツールには「読み取り専用か」を示す注記(readOnlyHint)が付いています。
| ツール | 内容 | 読み取り専用の注記 |
|---|---|---|
list_dataset_ids / get_dataset_info | データセットの一覧と情報 | あり |
list_table_ids / get_table_info | テーブルの一覧と情報 | あり |
execute_sql_readonly | SELECT 文だけを実行 | あり |
get_query_results / get_job | 結果の取得、ジョブの状態の確認 | あり |
execute_sql | INSERT・DELETE・DROP TABLE などを含む任意のSQL | なし(破壊的) |
cancel_job | 実行中のジョブの中止 | なし(破壊的) |
確認できた点は次のとおりです。
execute_sqlの説明文には、表やデータセットの削除(DROP TABLE・DROP SCHEMA)の例が載っています。読み取り用と並んで、権限さえあれば更新・削除も実行できるツールが用意されています- どちらの実行ツールにも
dryRun(実行せず、処理されるバイト数などを返す)、jobTimeoutMs(サーバー側の打ち切り時間)、labelsがあります。処理量の上限を指定する引数は一覧にありませんでした - 実行されたクエリには
goog-mcp-server: trueというジョブのラベルが自動で付き、projectIdに指定したプロジェクトに課金されると説明文に書かれています
BigQueryのMCPサーバーの公式ドキュメント(Use the BigQuery MCP server)には、次の制限も書かれています。
- 2つの実行ツールは、既定でクエリの処理時間を3分に制限し、それを超えると自動で中止する。結果は最大3,000行まで
- MCPサーバー自体には割り当て(クォータ)がなく、呼び出し回数の上限もない。ツールが呼ぶBigQueryのAPI(クエリなら
jobs.Query)の割り当てがそのまま効く
クエリを実行するツールは呼び出していません。一覧は10月2日時点のもので、変わる可能性があります。
スキルは「確認してから」を指示するが、強制ではない
公開リポジトリ(GoogleCloudPlatform/data-agent-kit-plugin、v1.0.0、2026年9月29日)のスキルを読むと、慎重な手順がいくつも書かれています。
bigquery-sql: 不要な列を外す、WHEREを早めに効かせるといった最適化を常に適用し、UNIONをUNION ALLに変えるような結果が変わりうる書き換えは確認してから行うbigquery-graph-author: プランの承認前にDDLを作らず、実行前にドライランする。処理量の見積もりが大きい検証クエリは、規模を伝えてから流すdbt-bigquery: 「NEVER executedbt runwithout explicit user confirmation」bigtable-basics: 本番のデータベースを変更する前に、ユーザーの明示的な確認を取る
公式ブログも、スキルがパーティションキーの確認や実行前のドライランを促すと説明しています。ただし、スキルはエージェントへの指示文です。ここからは編集部の整理ですが、スキルの指示は権限の代わりになりません。エージェントが指示に従わなかった場合や、データに埋め込まれた文章に誘導された場合に最後に効くのは、IAMとBigQuery側の設定です。
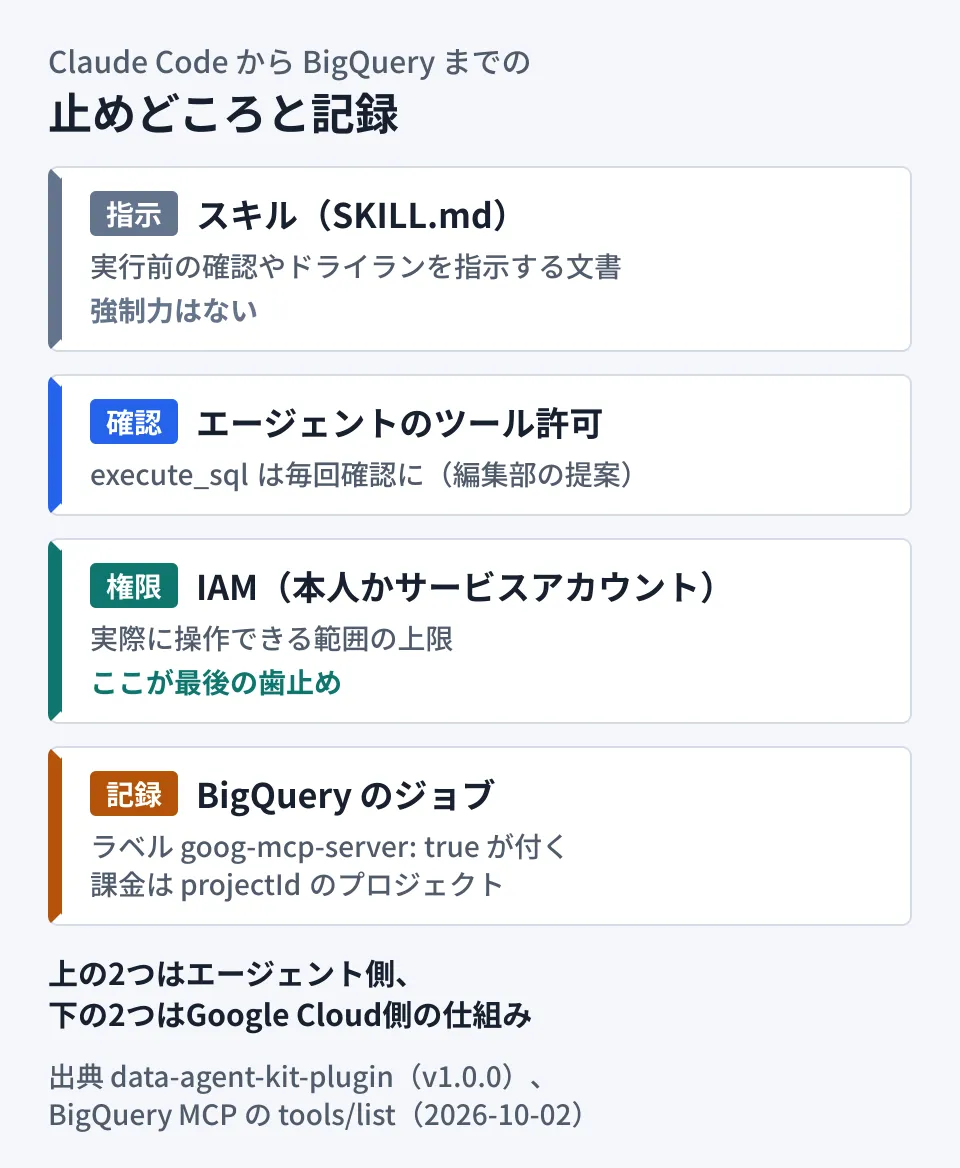
図の上の2つ(スキルとツールの許可)はエージェント側、下の2つ(IAMとジョブの記録)はGoogle Cloud側の仕組みです。ブログによると、エージェントはあなた自身として、またはなりすまし(impersonation)したサービスアカウントとして接続するため、行・列単位のセキュリティポリシーもそのまま適用されます。
Claude Codeに入れる流れ
READMEに書かれた前提と手順は次のとおりです。
- Node.js(LTS推奨)と gcloud CLI を入れ、
gcloud auth loginとgcloud auth application-default loginでログインする - プラグインを入れる
claude plugin marketplace add https://github.com/GoogleCloudPlatform/data-agent-kit-plugin
claude plugin install dak@dak-marketplace- 任意の指示を送るか
/dak:dak-setupを実行し、プロジェクトID、リージョン、使うサービス(BigQuery、Knowledge Catalogなど11種から選択)を答える - 指示に従ってエージェントを再起動する
公式ブログには別の手順として claude plugin install data-agent-kit-starter-pack@claude-plugins-official も載っています。この公式マーケットプレイスの登録先は別リポジトリ(gemini-cli-extensions/data-agent-kit-starter-pack)で、登録された版のREADMEには「currently in beta (pre-v1.0)」とありました。どちらを入れたかを社内で揃えておくと、後から設定を追いやすくなります。
そのほか、導入前に知っておきたい点があります。
- Codexでは、設定のときだけサンドボックスを外す(
codex -s danger-full-access)手順になっています - Claude Code向けの設定には、すべてのツール呼び出しの前に利用統計のスクリプトを動かすフックがあります。READMEによると、収集するのはスキルやツールを使った時点などで、コードやデータの値は含みません。環境変数
DO_NOT_TRACK=1などで収集を止められます
Claude Codeを組織で使う場合の全体の統制は、Claude Codeの全社導入の記事も参考になります。
つなぐ前に決めること(編集部の提案)
ここからは、上記の公式情報とツール一覧をもとにした編集部の提案です。
1. 本人のアカウントではなく、専用のサービスアカウントで
READMEのSecurityの節は、エンドユーザーの認証情報の代わりにサービスアカウントのなりすましを使い、必要なロールだけを付け、Principal Access Boundaryのポリシーでエージェントのサービスアカウントを想定したプロジェクトに限るよう勧めています。BigQueryのMCPサーバーのドキュメントは、使うプロジェクトで必要なロールとして、MCPツールの呼び出しに MCP Tool User(roles/mcp.toolUser)、ジョブの実行に BigQuery Job User(roles/bigquery.jobUser)、データのクエリに BigQuery Data Viewer(roles/bigquery.dataViewer)を挙げています。分析が目的なら、この3つを出発点にして、書き込みのできるロールは付けないのが基本です。
同じドキュメントによると、IAMの許可・拒否のポリシーでは、ツールの「読み取り専用」の属性やツール名を条件にできます。MCPの安全対策の資料(AI security and safety)も、本番のリソースに対しては拒否ポリシーで読み書きのツールを使わせないよう勧めています。
2. execute_sql は毎回確認にする
9月8日の公式ブログの事例では、IDEがMCPツールの使用前に許可を求め、「一度だけ許可」と「常に許可」を選べると説明しています。execute_sql_readonly を常に許可にしても、execute_sql は毎回確認のままにしておくのが安全です。Claude Codeでは --disallowedTools でツールを拒否できます(v2.1.287の claude --help)。プラグインのMCPツールがどの名前で登録されるかは未確認のため、導入後に実際の名前を確認して設定します。
3. 費用の上限はBigQuery側で
ツールの引数に処理量の上限がなく、MCPサーバーにも独自の割り当てがない以上、費用の歯止めはドライランとタイムアウトに加えて、BigQuery側に置く必要があります。BigQueryのドキュメント(Create custom query quotas)によると、1日に処理するデータ量の上限を、プロジェクト単位(QueryUsagePerDay)とユーザー単位(QueryUsagePerUserPerDay)で設定できます。既定値は、プロジェクト単位が1日200TiB、ユーザー単位は無制限です。ユーザー単位の値はサービスアカウントにも一律に適用され、特定のアカウントだけに別の値は付けられません。エージェント用のクエリを専用のプロジェクトで実行し、そのプロジェクトに課金を寄せると、費用を切り分けやすくなります。
4. 後から追えるようにする
MCPから実行したクエリには goog-mcp-server: true のラベルが付きます。ジョブの履歴をこのラベルで絞り込めば、エージェントが流したクエリと処理量を後から確認できます。外部の文章をデータとして読ませる場合は、READMEが案内するプロンプトインジェクション対策の資料にも目を通してください。MCP経由の権限設計の考え方は、MCPの認可の記事で扱いました。
まだ分からないこと
- IAMのロールと割り当ては公式ドキュメントで確かめましたが、実際にロールを付けて動かしてはいません
- Google Cloudのアカウントを使った実行はしていません。ツール一覧は取得しましたが、ツールの呼び出し、ドライランの結果、ラベルが実際に付くかは確かめていません
- 公式ブログ(公式マーケットプレイスのstarter pack)とREADME(dak-marketplace)でClaude Code向けの導入手順が異なり、どちらを推奨するのかは資料から判断できませんでした
2026年10月2日に、Google Cloud公式ブログの記事(2026年9月30日のGA告知、9月8日の「Agentic analytics with the Data Agent Kit」)、製品ページ、GoogleCloudPlatform/data-agent-kit-pluginのREADME・CHANGELOG・プラグイン設定・各スキルのSKILL.md、Claude Code公式マーケットプレイスの登録情報を直接開いて照合しました。BigQueryのMCPのツール一覧は、同日に
https://bigquery.googleapis.com/mcpへ認証なしでtools/listを送って取得したものです。2026年10月5日に、BigQueryのMCPサーバーのドキュメント、カスタムの割り当てのドキュメント、MCPの安全対策の資料を開いて、ロールと割り当ての記述を確かめました。プラグインのインストールと、実データへのクエリは実施していません。
BigQueryのデータをAIエージェントから使う仕組みづくりや、権限・費用の設計のご相談は、開発・AI・自動化のご相談としてグリームハブへお問い合わせください。
Sources
- Data Agent Kit is now GA: Bring Google Data Cloud to any coding agent — Google Cloud Blog(2026-09-30)
- Agentic analytics with the Data Agent Kit — Google Cloud Blog(2026-09-08)
- Data Agent Kit — Google Cloud 製品ページ
- GoogleCloudPlatform/data-agent-kit-plugin — README
- GoogleCloudPlatform/data-agent-kit-plugin — CHANGELOG
- GoogleCloudPlatform/data-agent-kit-plugin — .claude-plugin/mcp.json
- GoogleCloudPlatform/data-agent-kit-plugin — skills(bigquery-sql / bigquery-graph-author / dbt-bigquery / bigtable-basics / dak-setup)
- anthropics/claude-plugins-official — marketplace.json
- Use the BigQuery MCP server — Google Cloud ドキュメント
- Create custom query quotas — BigQuery ドキュメント
- AI security and safety — Google Cloud MCP servers ドキュメント
- gemini-cli-extensions/data-agent-kit-starter-pack — README