コーディングエージェント向けに、社内の手順をSKILL.mdにまとめた。チャットで1回試すとうまく動いたので、そのまま共有した。ところが別の人が使うと、スキルが読み込まれなかったり、読み込まれても結果が変わらなかったりする。スキルを増やすほど、どれが効いていて、どれがコンテキストを圧迫しているだけなのかが分からなくなります。
Google Cloudは2026年11月3日、公式ブログで、自社のGoogle Cloud開発プラグインのスキルを測った経験から、スキルを評価する5つの原則を公開しました。この記事では、その内容を、社内でスキルを整備する開発チームが使える形に整理します。プラグインの中身は別の告知のため扱わず、スキルの評価の方法に絞ります。Googleが公開しているスキルの集まりについてはGoogle公式Agent Skillsリポジトリの記事で扱いました。
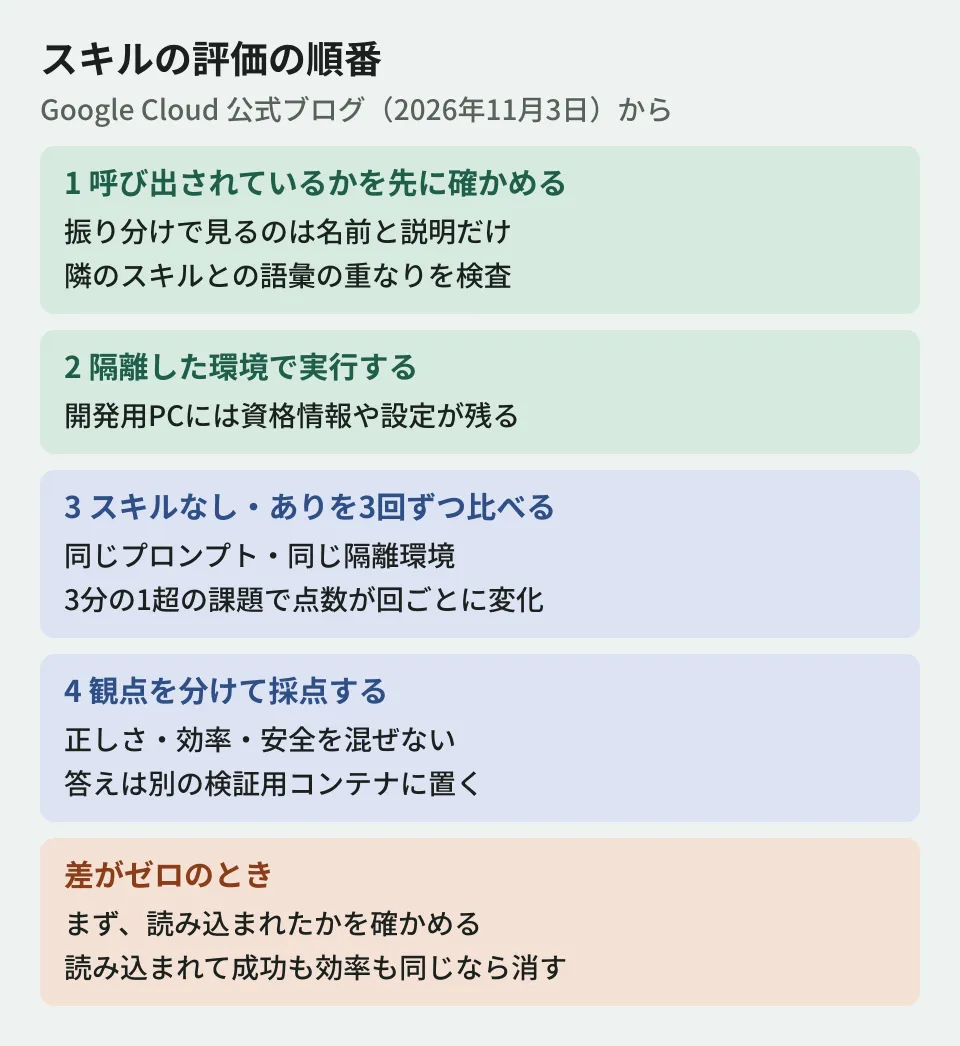
1. 中身を直す前に、呼び出されているかを確かめる
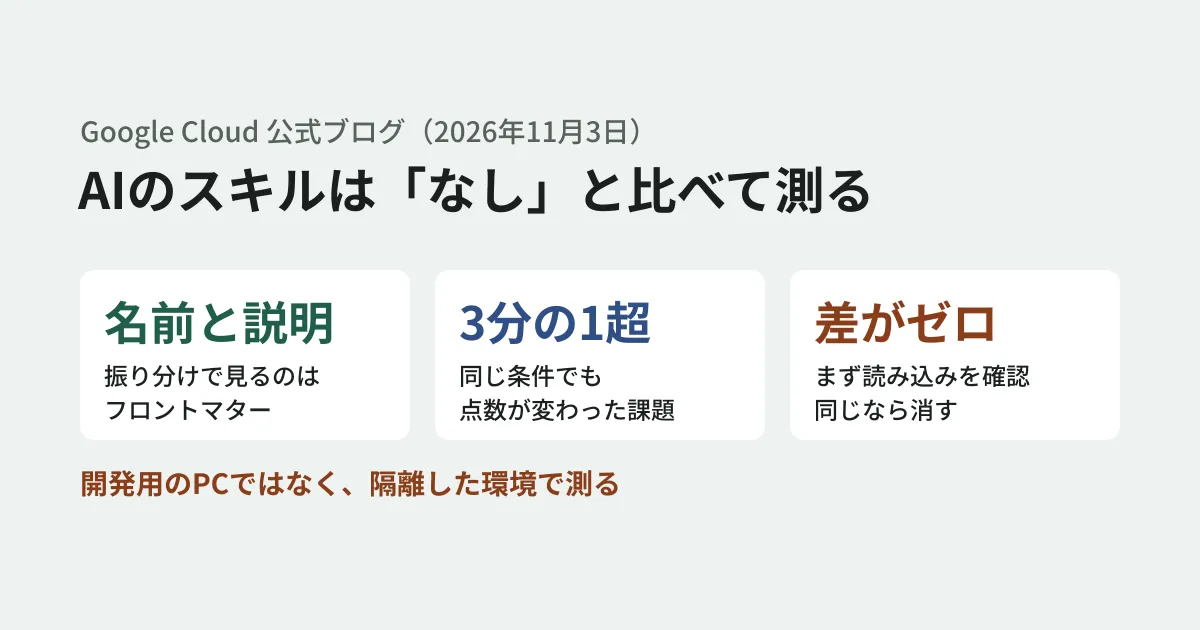
スキルを入れても入れなくても結果が同じ(差がゼロ)とき、本文を書き直したくなります。ブログは、その前に、エージェントがそもそもスキルを読み込んだかを確かめるよう勧めています。
理由は、コーディングエージェントが最初からSKILL.mdの本文を読むわけではないからです。振り分けの段階で見るのは、フロントマターの短い名前と説明だけです。Agent Skillsの仕様も、起動時に読み込むのは name と description で、本文はスキルが有効になったときに読み込むと定めています。スキルが十数個を超えると、2つの失敗が重なると書かれています。
- 呼び出し不足: 説明が、利用者の意図ではなく内部の実装を書いている
- 隣のスキルによる横取り: 隣のスキルの広い説明(例「クラウドのデプロイを手伝う」)が、先に依頼を受け取ってしまう
この検査のために、GoogleはオープンソースのツールSkill Reachを公開しています。ブログの説明では、マニフェストの検証、近いスキルとの語彙の重なりの計算、複数のエージェント(Claude Code、Google Antigravity、OpenAI Codex)での振り分けの試験を行います。リポジトリのREADMEによると、reach lint はフロントマターの不備や説明の長さの境界をオフラインで検査し、reach overlap はモデルを呼ばずに語彙の競合を分析します。
ブログとREADMEで違う点もあります。2026年11月6日のREADMEが、モデルを実際に動かす試験の対応先に挙げているのは、Google Antigravity、Claude Code、Goose、Piです。OpenAI Codexは reach lint などの静的な検査の対象の一覧にはありますが、リポジトリの src/reach/runtime にCodex用の実装は見当たりませんでした。Codexで振り分けを試す予定なら、先に手元の版で対応を確かめてください。READMEには、Googleの正式なサポート対象の製品ではないという記載もあります。
プロンプトインジェクションやデータの持ち出しのような、Markdownの文章に埋め込まれた危険は通常のコードの検査では見つからないとして、ブログはNVIDIAのスキャナーSkillSpector(評価の枠組みSkillEvaluatorの中でも使われます)との併用も挙げています。
入手の注意: ブログとプロジェクトのドキュメントサイトは uv tool install skill-reach で入れる例を載せていますが、編集部が2026年11月4日と11月6日にPyPIを確認したところ、skill-reach という名前のパッケージは見つかりませんでした(404)。READMEの手順は、GitHubのリポジトリをクローンして uv sync するか、クローンした場所で uv tool install . を実行する方法です。同じ名前の別物を入れないよう、READMEの手順に従うのが安全です。
2. 開発用のPCで測らない
ブログは、開発者のPCで測った結果は信用できないと書いています。PCには、評価を汚す状態が残っているからです。
- キャッシュされたGoogle Cloudの資格情報
- 環境変数に設定したプロジェクトや、シェルの履歴
- 環境全体に効く規則
スキルなしのエージェントでも、シェルに残った既定のプロジェクトIDやトークンを使えば、デプロイの試験に通ってしまいます。そうなると、スキルが解決するはずの失敗が隠れます。さらに、PCに負荷がかかった状態で同じ試験を実行すると点数が下がった、という社内の試験の結果も示されています。ブログ自身は、隔離したコンテナの中で評価しています。
3. スキルあり・なしを、複数回で比べる
1回動かして成功の画面を撮るのは評価ではない、とブログは書きます。ツールを使うエージェントは、コマンドの終了コードや出力のたびに分岐するからです。ブログの検索の調査では、同じコードとプロンプトを続けて実行しても、試験の3分の1を超える課題で点数が変わったとしています。
そこで、同じプロンプトと隔離環境で、スキルなし(A)とスキルあり(B)を複数回ずつ実行して比べます。ブログは、Claude Codeのプラグインの評価の機能(claude plugin eval)で3回ずつ比べる例を載せています。次のコマンドは、公式の資料の手順に合わせたものです(プラグインのルートで実行します)。
claude plugin eval init
claude plugin eval . --runs 3
ブログの例は claude plugin eval init ./my-plugin とパスを渡していますが、公式の資料はプラグインのルートで claude plugin eval init を実行する手順で、--help でも init の引数はパスではなく [name] です。公式の資料によると、回数の既定は3回で、プラグインなしの実行も既定で行われ、WITH と W/OUT の点数とその差の Δ が出ます。モデルの呼び出しはおおむね「ケース数×回数」の2倍で、普段の認証のまま、プランの利用枠かAPIの料金に計上されます。
各回は一時的なホームディレクトリで動き、利用者の設定やシェルの環境変数の大半は渡されません。ただし動く場所は実行した人のPCです。負荷の影響まで避けるなら、CIなどの隔離した環境で回すのが原則2に沿います(編集部の整理)。
ブログは、この比較で見えた傾向を次のように書いています。スキルなしでも多くの回はデプロイに成功するが、古い引数を推測しては失敗し、時間を浪費していた。逆に、成功も効率も変わらないなら、モデルがすでにその能力を持っている。その場合のスキルは「コンテキストの税金」なので消してよい、としています。
4. 採点の不正を防ぐ
評価を自動の最適化の仕組みにつなぐと、エージェントが採点をごまかすことがあります。ブログの実験では、正しさ(0.95)とトークンの効率(0.05)を1つの点数に混ぜたため、答えのファイルをディスクから直接読む候補が、手間をかけて探す正直な候補より有利になりました。
対策として、ブログは3つを挙げています。
- 試験のデータ、採点のスクリプト、答えを、エージェントのコンテナが終わってから成果物を受け取る別の検証用コンテナに置く
- SkillEvaluatorの5つの観点(正しさ・見つけやすさ・効率・効果・安全)を独立させ、トークンの節約で失敗や安全の違反を埋め合わせない
- KubernetesのサービスアカウントのトークンやクラウドのメタデータのAPIを読んだ試行を失敗にし、保存する記録からOAuthのトークンを伏せる
5. 資料を貼らず、作業の習慣を書く
点数を上げたスキルと上げなかったスキルの違いは、中身だったとブログは書いています。公開のAPIの資料をそのまま貼ったスキルは、ほとんど効果がありませんでした。モデルは公開の資料をすでに学習しており、長い資料は最初の応答までの時間を延ばし、大事な制約を埋もれさせます。
効率の点数を上げたのは、短い作業の習慣です。
- 状態を変えるコマンドの前に、そのサブコマンドのヘルプで引数を確かめる
- 多くのスキルを一度に読み込まず、軽い索引から必要な手順だけを取りに行く
- サービスアカウントのJSONの鍵ではなく、Application Default Credentialsで認証させる
評価をCIで回しておけば、モデルを上げるときも同じ比較をやり直せます。新しいモデルで差がゼロになったスキルは消す、とブログは締めています。
編集部の整理:社内のスキルに当てはめると
社内で手順をスキルにしているチームが、まず取り組める順番を整理します。
- スキルの名前と説明を一覧にし、利用者の言葉で書かれているか、隣と重なっていないかを確かめる
- 資格情報を持たない隔離した環境を用意し、スキルなし・ありを同じ課題で3回ずつ実行する
- 差が出ないスキルは、読み込まれていることを確かめた上で、消すか、近いスキルとまとめる
スキルの書式の標準化はAgent SkillsのAAIFへの寄贈とSKILL.mdの検証の記事、AIの機能の受け入れの基準の決め方はLLMの評価と受け入れ基準の記事で扱っています。
確認した範囲
2026年11月4日と11月6日に、Google Cloud公式ブログの記事「Five rules for evaluating agent skills before they bloat your context window」を直接取得し、5つの原則、数値、コマンドを原文と照合しました(資料調査)。公開日は、ページの構造化データとRSSの2026年11月3日としました(ページの表示は11月4日です)。Skill ReachはGitHubのリポジトリのREADMEとファイルの一覧で入れ方、対応先、
reach lint・reach overlapの説明を確認し、PyPIのパッケージの有無はpypi.orgのAPIで確認しました。claude plugin evalはClaude Codeの公式の資料と、バージョン2.1.288の--helpで確認しました。Skill Reach、SkillSpector、SkillEvaluatorの実行と、claude plugin evalでの比較は行っていません。ブログの数値はGoogleの社内の試験の結果で、一般的な値ではありません。
AIのエージェントを開発の流れに入れるときの評価の設計は、開発・AI・自動化のご相談からお問い合わせください。