
「Coderをセルフホストできることは分かった。では、モデルも手元で動かして、実際にコードを直せるのか」。前編の構成解説を、今回はMacで確かめました。
今回の構成では、Coder AgentsがDockerのWorkspaceを作り、Pythonの関数を修正し、4件のテストをすべて通しました。 使用したモデルは、このMacのOllamaで動かした qwen3.5:4b です。途中で編集ツールの呼び出しに1回失敗し、引数を直して処理を続ける場面もありました。
検証日は2026年9月17日。セットアップと確認操作にはCodexを使い、対象製品そのものを起動して画面・ログ・ファイル差分を取得しました。以下のコード修正を実行したのは、Coder AgentsとローカルのQwenモデルです。実案件のコードや顧客データは使っていません。
何を動かしたか
Mac上でCoderのサーバーとOllamaを動かし、Docker Desktop上にPostgreSQLと検証用Workspaceを作りました。外部LLMのAPIキーは登録していません。
| 項目 | 検証時の環境・設定 |
|---|---|
| PC | Apple M3 Pro、メモリ18GiB |
| OS | macOS 26.5.2、arm64 |
| Coder | v2.37.1+22f4284、macOS用の公式バイナリ |
| Docker | クライアント・サーバーとも25.0.3、Linux arm64 |
| DockerのVM | 8 CPU、メモリ約3.83GiB |
| データベース | PostgreSQLの postgres:17 イメージ |
| 推論サーバー | Ollama 0.34.1、Mac上で実行 |
| モデル | qwen3.5:4b、Q4_K_M、取得サイズ約3.39GB |
| コンテキスト | Ollama・Coderとも16,384トークン |
| Workspace | Python 3.12.14、git、curl。メモリ上限1GiB |
| Coder側のモデル設定 | OpenAI Compatible、最大出力4,096、temperature 0.2 |
ライセンスキーの追加や有償トライアルの有効化は行っていません。この表は動作した条件の記録であり、最低スペックや推奨構成を測定したものではありません。
接続先は次のとおりです。
ブラウザ → Coder(Macの127.0.0.1:3017)
              ├─ モデル要求 → Ollama(127.0.0.1:11437/v1)
              └─ ファイル操作・コマンド → DockerのWorkspace
Coderの処理と、LLMの推論は別のプロセスです。 今回は両方を同じMacに置きました。Workspace内のPython実行は、Docker DesktopのLinux環境で行われます。
接続先を登録するだけでなく、実際に応答を確認する
Macでは公式のスタンドアロンバイナリを使いました。CoderのDocker導入ガイドはLinuxホスト向けで、macOSにはスタンドアロンバイナリを案内しています。取得したCoder・Ollamaのアーカイブは、公式リリースのチェックサムと照合しました。
Ollamaでは qwen3.5:4b を取得し、まず単体で応答を確認しました。その後、Coderの Admin settings → AI → Providers にOpenAI互換のプロバイダーを登録し、Endpointを http://127.0.0.1:11437/v1 に設定しました。
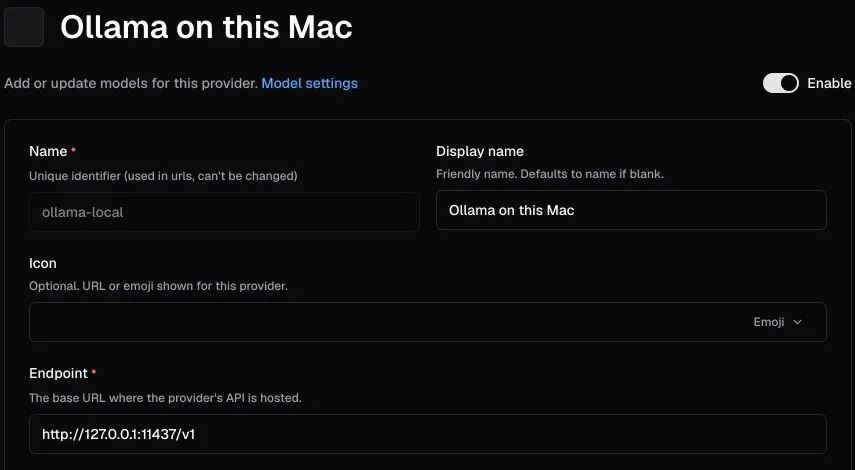
2026年9月17日に検証環境で撮影した実画面です。見るべき箇所は Endpoint。接続先を選ぶ設定と、モデル名を選ぶ設定は分かれています。
モデル側では qwen3.5:4b を指定し、既定のモデルにしました。今回のOllamaはローカルの認証なしAPIなので、Coderのキー欄には接続用のダミー値を使用しています。外部サービスのAPIキーではなく、他の人がアクセスできる環境にそのまま流用する設定でもありません。OllamaのOpenAI互換APIとCoderのモデル設定を併せて確認してください。
テストは先に用意し、AIには変更させない
題材は、ジョブの実行結果を集計する小さな関数です。実際のログではなく、次のような文字列を渡します。
["success", " SUCCESS ", "Failed", "", " ", "pending"]仕様は4つに絞りました。
successとfailedの件数を数える。- 前後の空白と英字の大文字・小文字を正規化する。
- 空文字・空白だけの文字列は無視する。
pendingなど未知の非空文字列はValueErrorにする。
用意した元のコードは、文字列をそのまま辞書のキーに使うため、通常の集計しか通りません。
def summarize_statuses(statuses):
    counts = {"success": 0, "failed": 0}
    for status in statuses:
        counts[status] += 1
return counts4つの仕様に対応するテストを先に配置しました。Coderへの指示には「最初にテストを実行する」「summary.py だけを直す」「テストを書き換えない」「最後に再実行し、git diffを示す」を含めました。今回の入力は英語です。日本語の指示で同じ結果になるかは検証していません。
今回使ったWorkspaceテンプレートと再現手順をダウンロードする
ZIPにはDockerfile、Terraformテンプレート、テストを作る処理、実際の依頼文、修正差分、実行結果を含めています。モデル本体、認証情報、顧客データは含みません。準備にはインターネット接続と数GBのダウンロードが必要です。
実行結果:3件のエラーから、4件すべて成功へ
Coder Agentsの画面から依頼すると、gh-media-python-lab テンプレートを探し、Workspaceを作成しました。READMEとコード・テストを読み、python -m unittest -v を実行しています。
| テスト | 修正前 | 修正後 |
|---|---|---|
| 通常の件数集計 | 成功 | 成功 |
| 空白・大文字小文字の正規化 | KeyError | 成功 |
| 空文字の無視 | KeyError | 成功 |
| 未知の状態をValueErrorにする | KeyError | 成功 |
ただし、一直線に成功したわけではありません。最初の edit_files 呼び出しでは、ファイル編集の配列が必要な場所に文字列を渡し、次のエラーになりました。
invalid parameters: json: cannot unmarshal string into Go struct field
EditFilesArgs.files of type []workspacesdk.FileEditsCoder側のエージェントはエラーを受け、引数を配列形式に直して再実行しました。この修正への人手の介入はしていません。 モデルとツールの接続確認では、最終回答だけでなく、こうした途中の失敗も見る必要があります。
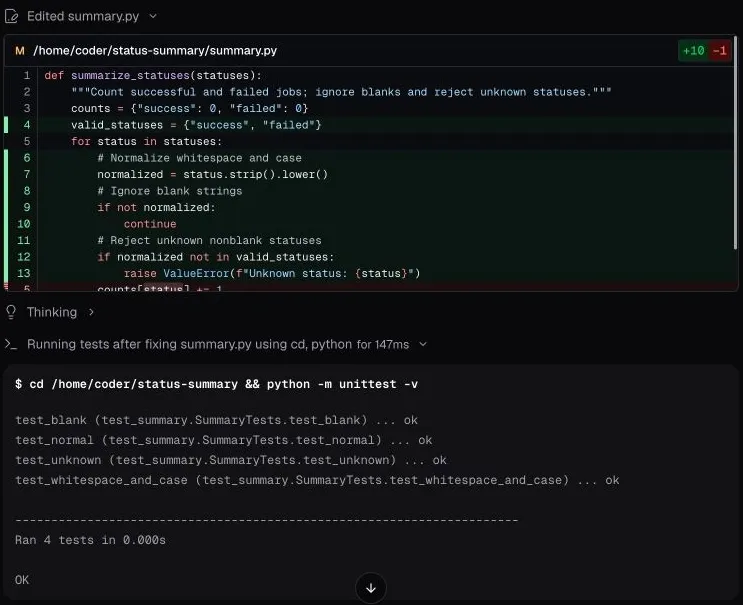
2026年9月17日の実画面を切り出しています。上がコード差分、下がWorkspace内で実行したテスト出力です。小さい文字は画像を拡大して確認できます。
test_blank ... ok
test_normal ... ok
test_unknown ... ok
test_whitespace_and_case ... ok

Ran 4 tests in 0.000s
OK上の出力はテスト名のクラス修飾部分を省略して掲載しています。0.000s は小さな単体テスト部分の表示であり、AIの推論・修正にかかった時間ではありません。
完了後、こちらからもコンテナ内で同じテストを実行して、終了コード0を確認しました。テストファイルは初期コミットと同一で、SHA-256も一致しています。変更された追跡対象ファイルは summary.py だけでした。Pythonの実行に伴う __pycache__ は別途生成されています。
今回確認できたのは、既知の仕様と4件のテストに対する1回の修正です。大きなリポジトリでの開発能力、長時間の自律作業、他モデルとの性能差を示す結果ではありません。
LLMを止めると、Coderはどうなるか
コード修正の完了後、Ollamaだけを停止しました。Coderのサーバーはそのままにし、別の会話で「READYとだけ返す」という接続確認用の依頼を送っています。
画面には Request timed out とプロバイダーの一時的な利用不能、再試行までの残り秒数が表示されました。Coderのサーバーログには、実際の接続先と理由が残っています。
Post "http://127.0.0.1:11437/v1/chat/completions":
dial tcp 127.0.0.1:11437: connect: connection refused
Ollamaを再起動すると、自動再試行で READY が返りました。依頼を送り直してはいません。
この結果から、運用監視では CoderのWeb画面が開くか と モデルまで到達して応答を得られるか を分けて見るのがよいと考えます。画面のエラー見出しだけでは、タイムアウトと接続拒否の違いまでは分かりませんでした。
「ローカルで動いた」と「完全な閉域環境」は分けて判断する
修正の実行中、OSの接続一覧で coder プロセスから 127.0.0.1:11437 のOllamaへのTCP接続を確認しました。モデルを止めると同じ宛先への要求が失敗したことも、上記のログで追えます。
Workspaceは非rootの coder ユーザーで動き、マウントは検証用ホームディレクトリのDockerボリューム1つでした。ホストのソースコードやDockerソケットはWorkspaceへマウントしていません。LLMプロバイダーのキーも、Workspaceのコンテナ環境変数には渡していません。
一方、全外向き通信を記録・遮断する試験はしていません。セットアップ時にはモデル、Dockerイメージ、Terraformプロバイダー等をインターネットから取得しています。Coderの通常テレメトリーと更新確認、Ollamaのクラウド機能は無効にしましたが、それだけで他の通信がないとは判断していません。
また、CoderのAgentsのライセンス・利用量に関する公式説明には、利用量報告用の通信が別に説明されています。推論先をローカルにしたことを、全体の閉域性や監査要件の充足に読み替えることはできません。
社内で次に試すなら
今回の検証で、手元の小さな課題をCoder AgentsとローカルLLMで処理するところまでは確認できました。導入を進める場合は、次の試験を自社の条件で追加します。
| 次の疑問 | 試す内容 |
|---|---|
| 自社のコードでも役に立つか | 公開可能な代表課題を複数用意し、既存テストと人のレビューで評価する |
| 読ませたくない情報に触れないか | 別ユーザー・別リポジトリ・秘密情報へのアクセスを拒否する試験 |
| 許可した先以外に通信しないか | 制御基盤とWorkspaceの両方で宛先を記録し、許可リストを検証する |
| 必要な記録を残せるか | 会話・ツール実行・認証操作について、閲覧権限と保存・削除・復元を確認する |
| 継続して使えるか | 同時利用、長い会話、モデル停止、サーバー更新後の再実行を確かめる |
この5項目は今後の検証項目で、今回すべて確認済みという意味ではありません。モデルを選ぶ際も、小さなテストが通ることに加えて、失敗から戻れるか、変更をレビューできるかまで見ると判断しやすくなります。
検証範囲や通信・権限の条件を整理したい場合は、対象の開発環境と、外部へ送信できない情報の範囲を添えてお問い合わせフォームからご相談ください。
