社内システムに組み込んだ Claude の呼び出しが、ある日から遅くなった。どの機能のどのリクエストで時間がかかっているのか、ツールの呼び出しで止まっているのか、アプリのログだけでは切り分けにくい。月末に届く請求額を見て、どの機能がトークンを使っているのかを後から探すことになる。
2026年10月14日、Claude Platform のリリースノートに、Messages API のリクエストと Claude Managed Agents のセッションを OpenTelemetry のトレースとして出力する機能(ベータ)が載りました。Datadog・Grafana Cloud・New Relic・Sentry など、OTLP を受け付ける監視基盤にそのまま送れます。
便利な一方で、設定によってはプロンプトと応答の全文が社外の監視サービスに保存されることになります。本記事では、公式ドキュメントの記述と、編集部の検証環境で TypeScript SDK を動かした結果をもとに、組み込む前に決めておく点を整理します。
SDKのトレースとAPIのトレースは別物
公式ドキュメント(OpenTelemetry for the Claude API)は、トレースの取り方を2つに分けています。
- SDK のトレース: アプリの中で Claude SDK が span を作り、アプリの OpenTelemetry の仕組みで送る。設定はコードで行い、特別な権限は要らない
- API のトレース: Anthropic 側が span を作り、Claude Console に登録した送信先(destination)へ直接送る。登録には組織の admin ロールが要る
API のトレースでしか見えないものもあります。1回のリクエストの中で何回モデルが動いたか、Web 検索などのサーバー側ツール、Managed Agents のターンです。逆に、SDK のツールランナーが実行したクライアント側のツールや、ファイルのアップロードなど Messages 以外のリクエストは SDK のトレースにしか出ません。両方を設定すると、1つのトレースの中に両方の span が並びます。
注意したいのは、API のトレースが使える環境です。ドキュメントの表では、対応は Claude Platform と Claude Platform on AWS だけです。Amazon Bedrock や Google Cloud の Vertex AI 経由で Claude を使っている場合は、SDK のトレースだけになります。
決めること1:プロンプトと応答を送るか
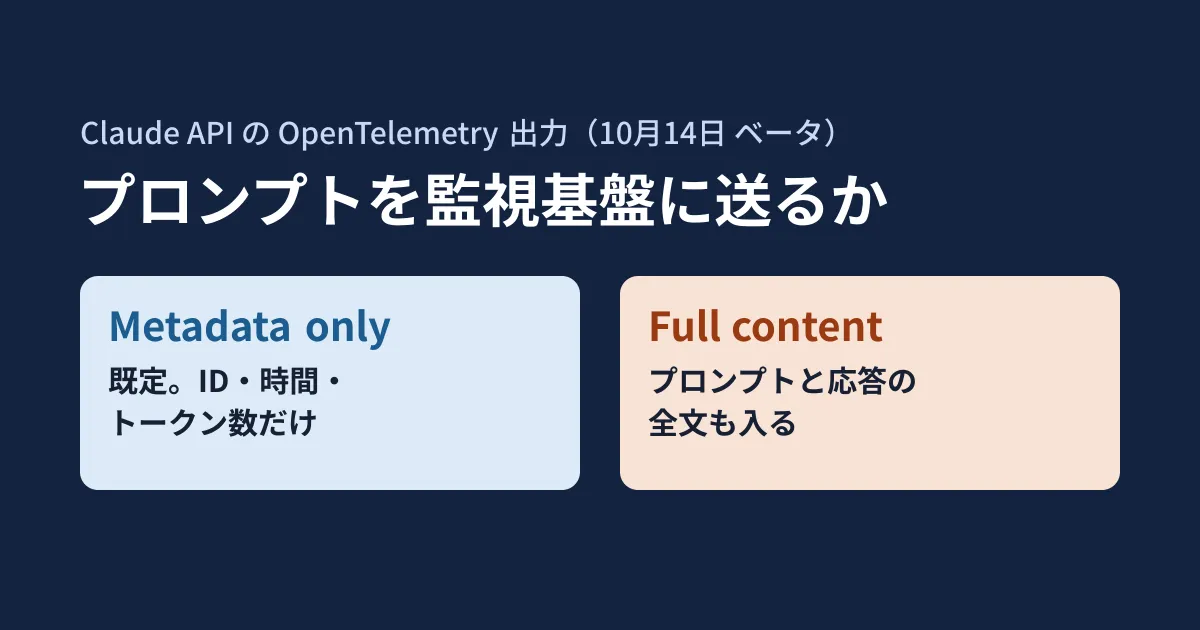
送信先と SDK のクライアントには、それぞれ「コンテンツモード」があります。
- Metadata only(SDK では
metadata_only): 既定値。ID、時間、ステータス、トークン数などが入る - Full content(SDK では
content): Metadata only の内容に加えて、プロンプトと応答の全文が入る
ドキュメントは、Full content にすると、送った先の監視サービスがそのアクセス権と保存期間の設定で内容を保管すると注意しています。顧客の問い合わせ文や社内文書をプロンプトに入れている処理では、監視サービスの閲覧権限を持つ人が、その全文を読めることになります。
編集部の検証環境で、TypeScript SDK 0.134.0 を使い、ローカルに立てたスタブのサーバー(Messages API の形の固定の応答を返すもの)へリクエストを送って、SDK が作る span の属性を調べました。プロンプトに目印の文字列を入れ、両方のモードで比べた結果です。
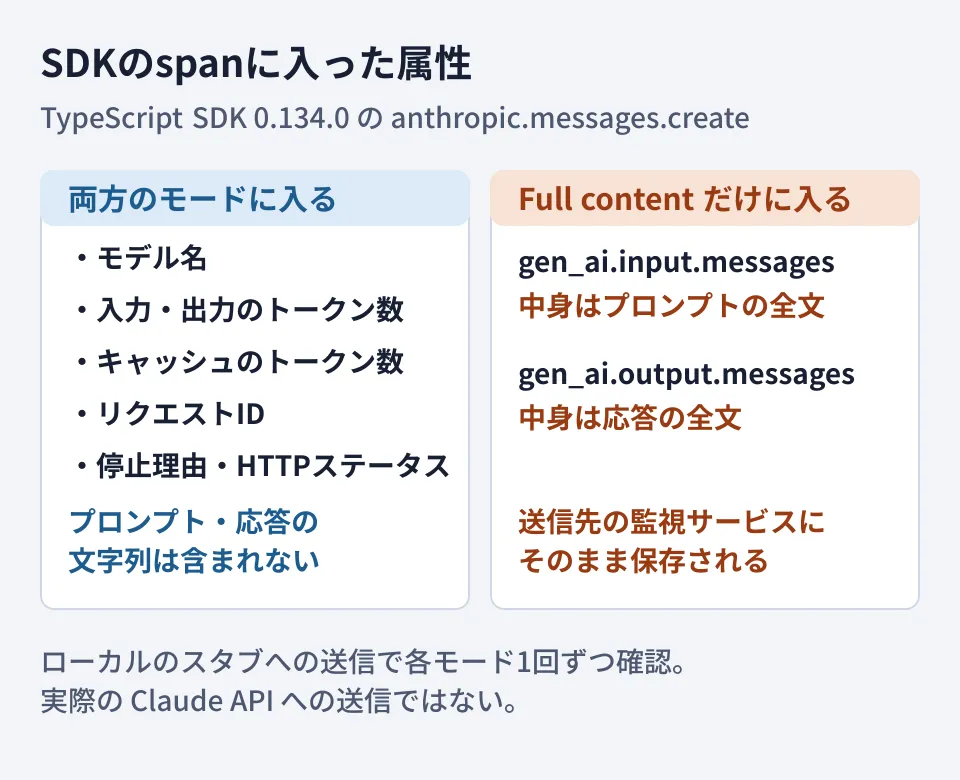
Metadata only の span には、モデル名(gen_ai.request.model)、入出力とキャッシュのトークン数(gen_ai.usage.*)、リクエストID(anthropic.request.id)、停止理由、HTTP のステータスなど20個の属性が入り、プロンプトの文字列も応答の文字列も含まれていませんでした。Full content にすると、gen_ai.input.messages と gen_ai.output.messages の2つが加わり、両方の文字列が入っていました。なお、ドキュメントによると、Full content ではシステムプロンプトも gen_ai.system_instructions に入ります(今回の検証の出力にはこの属性はありませんでした)。
この結果から、編集部としては次の順番を提案します。
- まず Metadata only で始め、遅延・エラー率・トークン数の傾向を見る
- 原因の調査に本文が必要になったら、本番とは別の送信先を Full content で用意し、検証用のワークスペースに限って使う
- 本番で Full content を使うなら、監視サービス側の閲覧権限と保存期間を先に決める
なお、組織に HIPAA・FERPA・K-12 のデータの取り扱いの制限がある場合、API の送信先は設定にかかわらず Metadata only になります(SDK の span は対象外)。ゼロデータ保持(ZDR)の契約でも Full content は使え、Messages API の内容は送信先に届けるまでメモリ上にだけ置かれると書かれています。
会話IDに個人情報を入れない
SDK には、複数の呼び出しを1つの会話としてまとめる conversation_id(TypeScript では conversationId)があります。ドキュメントは「The ID is exported in both content modes, so don’t put personal data or secrets in it.」としています。Metadata only でも送られるため、メールアドレスや会員番号をそのまま入れず、社内で引き当てられる別のIDにします。
決めること2:トークン数をどこで数えるか
トレースにはトークン数が入るため、機能ごとの使用量の集計に使いたくなります。ただし、ドキュメントの「Counting tokens」には、二重に数えないための決まりが並んでいます。
- SDK と API の両方のトレースがあるリクエストは、API 側の span だけを合計する。どちらも
anthropic.messages.createという名前で、SDK 側は種類がCLIENT、API 側はSERVER - API 側では、
anthropic.messages.createか、その下のanthropic.model_requestのどちらか一方だけを合計する gen_ai.usage.input_tokensには、キャッシュの読み取り・書き込みのトークンがすでに含まれている
さらに、配信は「At least once」(同じ span が複数回届くことがある)かつ「Best effort」(届かずに失われることがある)です。ドキュメントは、トレースは API の利用の完全な記録ではないとし、API キーごとの使用量の把握には Usage API を使うよう案内しています。
編集部の整理としては、トレースは遅延と原因の調査、請求額の照合は Usage API と役割を分けるのが安全です。ダッシュボードでトークン数を合計する場合は、トレースID と span ID で重複を除き、合計する span の名前と種類を固定しておきます。
決めること3:送信先と範囲
API のトレースを送る送信先には、次の条件があります(Set up API tracing の「What you need」「Delivery and health」「Limits」)。
| 項目 | 条件 |
|---|---|
| 受け口 | OTLP/HTTP(protobuf)、HTTPS の443番ポート。URL は IP アドレスではなくホスト名 |
| 止まる条件 | 3xx のリダイレクトを返す、ホスト名が公開されていない IP アドレスに解決される、24時間すべての配信が失敗する |
| 応答時間 | TLS のハンドシェイクと応答ヘッダーはそれぞれ5秒以内、1回の配信は合計10秒まで |
| 上限 | 1組織あたり送信先は10個(無効にしたものを含む) |
自前の OpenTelemetry Collector で受ける場合、OTLP/HTTP の受け口は既定で4318番ポートです。ドキュメントは、443番で HTTPS を受けるように設定するか、前にロードバランサーやリバースプロキシを置くよう書いています。社内ネットワークの中だけにある Collector には、そのままでは送れません。
送る範囲はワークスペース単位で選べます(すべて/選んだもの/選んだもの以外)。本番・検証・部署ごとにワークスペースを分けていれば、本番だけ Metadata only の送信先、検証だけ Full content の送信先、という分け方ができます。
自社のトレースにつなぐ
既定では、API 側の span は独立したトレースになります。アプリのトレースの下に並べるには、SDK のトレースを設定し、自社の span の中から SDK を呼びます。API は W3C の traceparent ヘッダーからつながりを読み取ります。今回の検証でも、SDK はスタブのサーバーへのリクエストに traceparent ヘッダーを付けていました。
ヘッダーの sampled フラグがオフのリクエストは、API 側の span が作られません。サンプリング率を下げている場合、API 側のトレースもその分だけ減ります。
組み込む前の確認リスト
ここまでの内容を、編集部が組み込み前の確認項目としてまとめると次のとおりです。
- 使っている経路を確かめる。 Claude API 直か、Claude Platform on AWS か、Bedrock・Vertex AI か。後の2つは SDK のトレースだけになる
- SDK の版を上げて固定する。 TypeScript SDK で
openTelemetryのオプションが入ったのは 0.134.0(npm の公開日時は2026年10月14日、UTC)で、0.133.0 には含まれていない。ドキュメントは、ベータの間は span や属性の名前が変わりうるため版を固定するよう書いている - コンテンツモードを送信先ごとに決める。 既定の Metadata only から始める
conversation_idに入れる値を決める。 個人情報や秘密情報を入れない- 送信先を誰が登録するか決める。 admin ロールが要る。外部の開発会社に任せる場合も、送信先のヘッダーに入れる監視サービスの API キーの管理者を決めておく
- トークン数の集計方法を決める。 合計する span と重複の除き方を固定し、請求の照合は Usage API で行う
外部の監視基盤に AI の呼び出しを集める設計は、既存のアプリ監視の延長で考えられます。OpenTelemetry への移行の考え方はAirbnb の事例で見る OpenTelemetry 移行、複数の AI サービスへの呼び出しを1か所で管理する設計はAIゲートウェイの記事、モデルの値下げが請求額に効くまでの考え方は安い新モデルが出ても、請求額は自動では下がらないで整理しています。
確認した範囲
2026年10月15日に、Claude Platform のリリースノートと OpenTelemetry のドキュメント(概要、Set up API tracing、Set up SDK tracing)を直接取得して確認しました(資料調査)。公開前の2026年10月16日に同じ資料を取得し直し、記述を照合しました。あわせて、編集部の検証環境(Linux、Node.js v22.22.0、
@anthropic-ai/sdk0.134.0、@opentelemetry/sdk-trace-node2.12.0)で、ローカルのスタブのサーバーに対して SDK の span をメモリ上に集め、両方のコンテンツモードで1回ずつ属性を確認しました(実機検証。実際の Claude API への送信ではありません)。Claude Console での送信先の登録、API 側の span、監視サービスでの表示、Python などほかの言語の SDK は確認していません。
Claude API を組み込んだ社内システムの監視の設計や、AI の呼び出しのログの扱いを決める作業は、開発・AI・自動化のご相談からお問い合わせください。