社内規程やマニュアル、FAQを検索できるようにしたい。あるいは、コーポレートサイトの記事をAIで答えられるようにしたい。Cloudflare AI Searchは、R2のファイルやWebサイトを読み込んで索引を作り、検索やAIの回答に使える仕組みです。ただ、日本語の文書で使う場合は、索引の作り方の既定値のままでは、キーワード検索がほとんど働かないことがあります。
2026年10月16日のCloudflareの変更履歴によると、AI Searchのキーワード検索は、trigram トークナイザーを使えば日本語・中国語・韓国語の質問文に一致するようになりました。これまでは、空白のない質問文全体が1つの完全一致の語句として扱われ、通常はキーワード検索の結果が返らなかった、と書かれています。
Previously, a query without spaces was treated as a single exact phrase and usually returned no keyword results.
AI Searchは10月1日に正式提供(GA)となり、2026年11月1日から従量課金が始まります。無料枠を超えた利用は課金の対象になるため、日本語で使う設定とあわせて、この時期に見直しておく価値があります。
キーワード検索の「トークナイザー」を変える
AI Searchの検索には、意味の近さで探すベクトル検索と、語の一致で探すキーワード検索(BM25)があります。新しく作るインスタンスは、両方を並行して実行し結果を合わせるハイブリッド検索が既定です。
キーワード検索では、文章を「トークン」に区切ってから一致を調べます。その区切り方を決めるのが、indexing_options の中の keyword_tokenizer です。
| 値 | 既定 | 区切り方(公式の説明) |
|---|---|---|
porter | はい | 空白と句読点で区切り、語尾の変化をそろえる(“running” が “run” に一致) |
trigram | いいえ | 3文字ずつずらした並びで区切る(“config” が “configuration” に一致)。公式はコード向けとしている |
キーワード検索のドキュメントは、既定の porter は空白で区切るため日本語・中国語・韓国語ではうまく働かず、結果が返らないことがあると注意しています。日本語の文書なら trigram を使うよう案内しています。
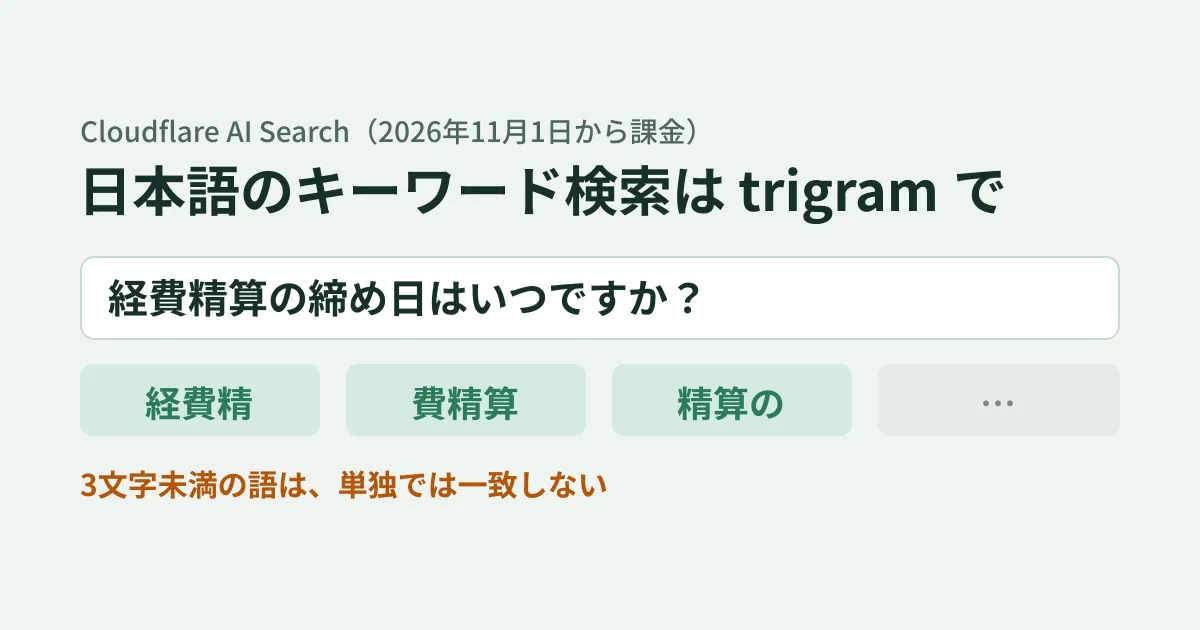
trigram は、文章を3文字ずつの重なった並びにして照合します。たとえば変更履歴の例の質問文「経費精算の締め日はいつですか?」は、「経費精」「費精算」「精算の」……のような3文字の並びの集まりとして扱われます。質問文の言い回しが文書と完全に同じでなくても、共通する3文字の並びで一致を探せる、ということです。
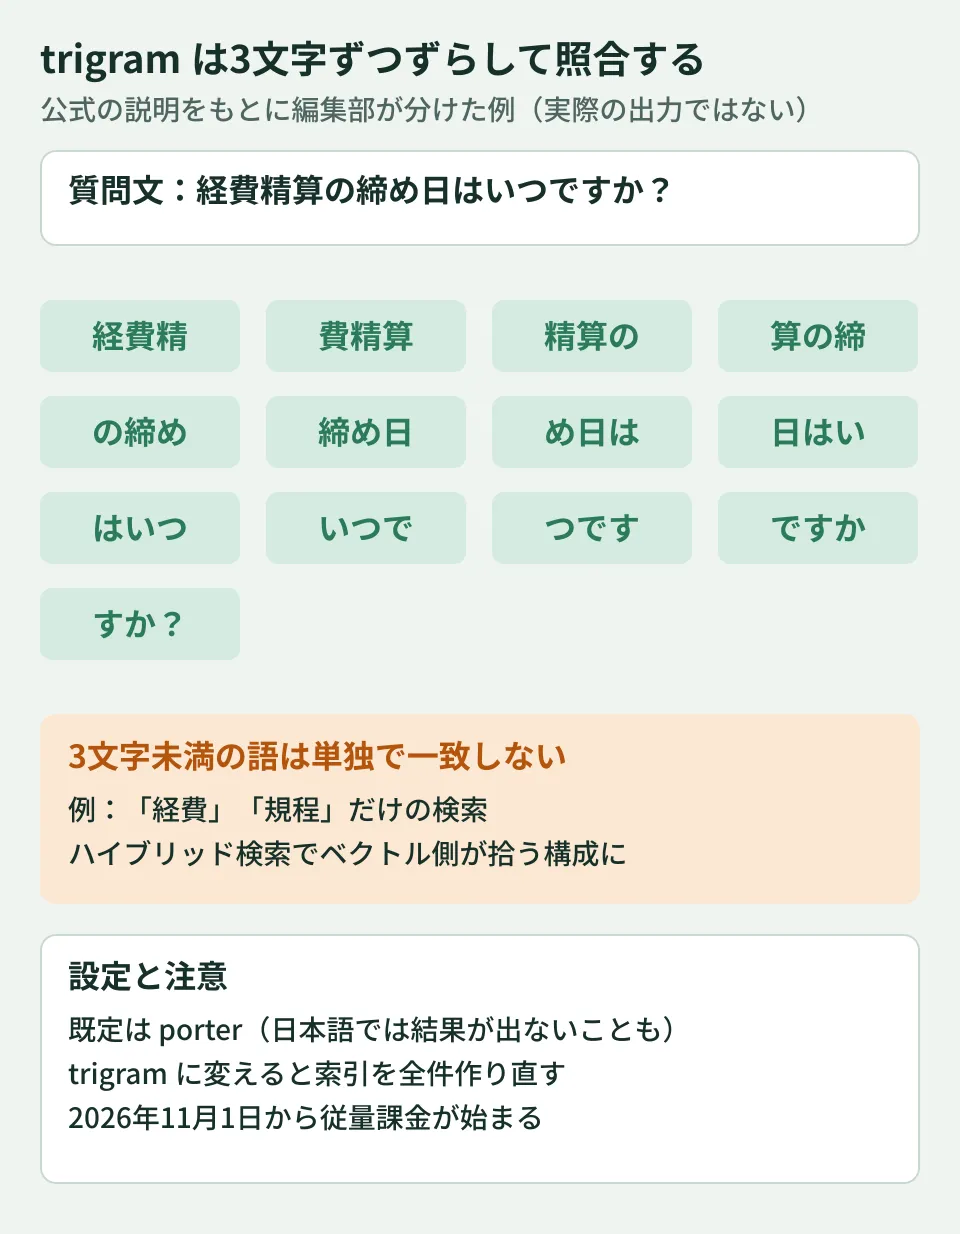
2文字の語は、単独では一致しない
同じドキュメントには、次の一文もあります。
Words shorter than three characters cannot be matched on their own.
日本語には「経費」「規程」「契約」「休暇」のような2文字の語があります。利用者がこうした語を1つだけ入力した場合、trigram のキーワード検索では一致しません。ここからは編集部の提案です。日本語で使う場合は、キーワード検索だけのインスタンスにせず、ハイブリッド検索(既定)のままにして、短い語はベクトル検索で拾う構成にします。検索欄の案内で「質問文で入力してください」と促すのも1つの方法です。
設定を変えると、索引を作り直す
keyword_tokenizer は、インスタンスの作成時か更新時に指定します。ドキュメントには、変更すると全件の索引の作り直し(full reindex)が始まると書かれています。文書の量が多いインスタンスでは、作り直しの間は検索結果が変わる可能性がある前提で、利用の少ない時間に変えます。次は、Workersのバインディングから作成するときに指定する例です(ドキュメントの例をもとに indexing_options を加えたもの。実行はしていません)。
const instance = await env.AI_SEARCH.create({
  id: "internal-docs",
  index_method: { vector: true, keyword: true }, // ハイブリッド検索(既定)
  indexing_options: { keyword_tokenizer: "trigram" },
});
11月1日からの料金と、無料で使える量
料金のページによると、課金は2026年11月1日に始まり、その前の週にCloudflareから案内のメールが届きます。毎月、次の量までは料金がかかりません。
- 取り込み(索引の作成):500万トークン
- 保存:10GB-月
- 意味検索(ベクトル・ハイブリッド):1,000回
- 全文検索:1,000回
超えた分の料金は次のとおりです。
| 項目 | 料金 |
|---|---|
| 取り込み | 100万トークンあたり0.75ドル(画像の処理は100万トークンあたり0.50ドルを追加) |
| 保存 | 1GB-月あたり2.00ドル |
| ベクトル・ハイブリッドの検索 | 1,000回あたり0.75ドル |
| 全文検索 | 1,000回あたり0.10ドル |
取り込みのトークン数は、分割した後の文書の断片(チャンク)を cl100k_base という方式で数えます。断片どうしの重なりの部分は、それぞれの断片で数えられます。埋め込み(ベクトル化)と並べ替えに使うWorkers AIの利用はAI Searchの料金に含まれますが、回答の生成やクエリの書き換え、外部のモデルの利用は別に請求されます。
スキャンしたPDFなどでOCR(画像から文字を読み取る処理)を使う場合は、取り出した文字が通常の取り込みに加えて「画像の処理」のトークンとしても数えられます。画像の処理のトークンは、取り込みの月500万トークンの無料枠を共有します。
社内向けの検索で1日30回程度(月20営業日で600回)なら、意味検索の月1,000回の無料枠に収まる計算です。一方、公開サイトの検索欄につなぐと、検索の回数は閲覧者の数で決まります。ハイブリッド検索は1回ごとに「意味検索」として数えられるため、公開サイトでは回数の見込みを立ててから使います。
上限
Workersの無料プランと有料プランで、主な上限は次のとおりです(料金と上限のページ)。
- インスタンスあたりのファイル数:無料プランは10万件。有料プランは100万件、ハイブリッド検索なら50万件
- 1ファイルの大きさ:テキストと、OCRを使うPDFは10MiB。OCRを使わないPDFとその他の形式は4MiB
- Webサイトの読み込み:無料プランは1日500ページまで
使い始める前に確かめること
公式資料からは分からない点があります。ここは自社の文書で試してから判断します。
- 日本語での検索の精度:ドキュメントには、
trigramで日本語の質問文に一致するとありますが、どの程度の精度で目的の文書が上位に来るかを示す数値はありません。社内でよく使う質問を20〜30件ほど用意し、porterとtrigramで上位の結果を比べます。複数の語の扱いを決めるkeyword_match_mode(既定はすべての語を含むことを求めるand、ほかにor)もあわせて比べます。この設定がtrigramの3文字の並びにどう効くかは、公式資料には書かれていません - ベクトル検索に使う埋め込みのモデル:日本語の意味検索の精度は、選ぶ埋め込みのモデルにも左右されます。対応するモデルの一覧から選び、同じ質問で比べます
- 既存のインスタンスの設定:10月より前に作ったインスタンスは、
porterのまま、あるいはベクトル検索だけになっている可能性があります。設定を確かめ、変える場合は索引の作り直しの時間を見込みます
検索の仕組みを自前で組む選択肢との比べ方は、SQLite 3.54.0のvec1でベクトル検索を試すが参考になります。社内のチャットの履歴を検索に使う場合は、Chat APIでメッセージ検索とピン留めも参照してください。
確認した範囲
2026年10月23日に、Cloudflareの変更履歴「AI Search keyword search supports Japanese, Chinese, and Korean queries」(2026年10月16日)と「AI Search is generally available」(2026年10月1日)、AI Searchのドキュメント(Keyword search、Hybrid search、Search modes、Limits & pricing、Workers bindingのAPI)を、公式ドキュメントのソースリポジトリ(cloudflare/cloudflare-docs)で確認しました(資料調査)。Cloudflareのアカウントでのインスタンスの作成、日本語の文書での検索結果と精度、索引の作り直しにかかる時間は確認していません。図の3文字の並びは、トークナイザーの説明をもとに編集部が質問文を分けて示したもので、AI Searchの実際の出力ではありません。公開前の2026年10月27日に、変更履歴とドキュメントの公開ページ、AI Searchの変更履歴の一覧を見直し、OCRの課金と
keyword_match_modeについて追記しました。10月16日より後に、AI Searchの変更履歴に新しい項目はありませんでした。
社内文書の検索やサイト内検索の設計・開発は、開発・AI・自動化のご相談からお問い合わせください。