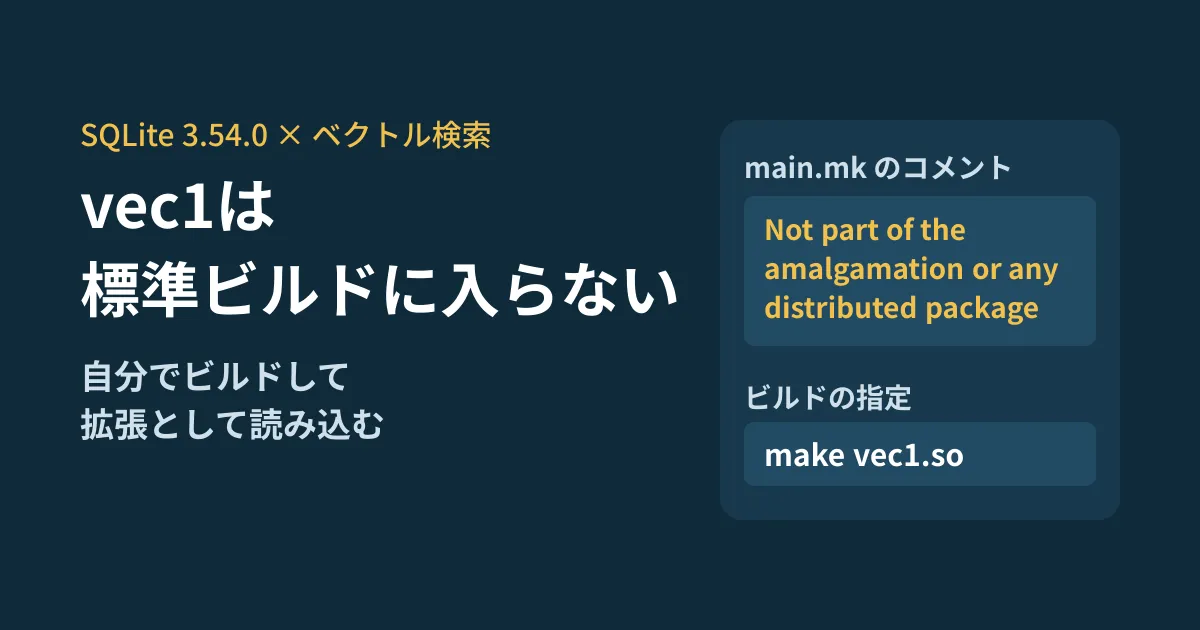
社内文書の検索やRAG(検索拡張生成)の試作で、ベクトルデータベースを別に立てずに、アプリに組み込んだSQLiteで済ませたい。そう考える開発者にとって、SQLite本体のリポジトリにベクトル検索の拡張「vec1」が入ったことは気になる話題です。
2026年10月9日付の version-3.54.0 タグには、ext/vec1/ にvec1のソースとテストが含まれています。ただし、ビルド設定のコメントには「amalgamation(1ファイルにまとめた配布用ソース)にも、どの配布パッケージにも含まれない」と書かれています。SQLiteを3.54.0に上げれば使える、というものではありません。この記事では、ソースと公式ドキュメントで確かめた位置づけと、編集部の検証環境でビルドして動かした結果を報告します。
vec1はSQLiteに同梱されず、自分でビルドする拡張
3.54.0のビルド設定(main.mk)には、vec1について次のコメントがあります。
vec1 loadable extension. Not part of the amalgamation or any distributed package; built only by explicitly running “make vec1.so”.
vec1.c の冒頭には、x86_64のgccで読み込み可能な拡張としてビルドする例(gcc -O3 -DNDEBUG -mavx2 -mfma vec1.c -shared -fPIC -o vec1.so)と、説明ページ(sqlite.org/vec1)の案内があります。ソース内のバージョンは 0.8 です。main.mk 経由でビルドすると、AVX2対応のCPUかどうかを実行時に判定する形にもできると説明されています。
つまり、sqlite3 コマンドや各言語に同梱されたSQLiteで、そのままvec1が使えるわけではありません。拡張をビルドし、拡張の読み込みを許可した接続で読み込む必要があります。2026年10月9日付のSQLite 3.54.0のリリースノートにも、vec1は載っていません。
vec1の説明ページ(sqlite.org/vec1)では、vec1はSQLiteの仮想表の仕組みで近似最近傍検索を行う拡張で、ユークリッド距離(L2)とコサイン距離に対応すると説明されています。ページ上の「現在のリリース」は0.7で、3.54.0のタグに入っているソース(0.8)とは版が異なります。今後の予定の節には「テストが不十分」とあり、1.0の前の段階です。
編集部の検証環境でビルドして動かした
2026年10月14日に、次の環境で試しました。
| 項目 | 内容 |
|---|---|
| OS・CPU | Linux x86_64、Intel Xeon 2.10GHz(4コア) |
| vec1 | version-3.54.0 タグの ext/vec1/vec1.c を gcc -O3 -DNDEBUG -mavx2 -mfma でビルド |
| SQLite | 3.54.0(Python用ライブラリ apsw 3.54.0.0 に含まれるもの) |
PythonのSQLite(この環境では3.45.1)ではなく、SQLite 3.54.0を含むapswから読み込みました。古いSQLiteで動くかは試していません。読み込み後の SELECT vec1_info() は version 0.8 (AVX2, multi-threaded) を返しました。
使った SQL は、テストファイル(ext/vec1/test/)の書き方に合わせています。
-- ベクトル列と、任意の付随データ列(ここでは文書名)を持つ仮想表
CREATE VIRTUAL TABLE docs USING vec1(vector, title);

INSERT INTO docs(rowid, vector, title)
  VALUES (1, vec1_from_json('[1,0,0,0]'), '請求書の発行手順');

-- 全件を比べる索引(flat)で作り直す
INSERT INTO docs(cmd, vector) VALUES ('rebuild', '{index:"flat"}');

-- 問い合わせのベクトルに近い3件
SELECT rowid, title, distance
  FROM docs(vec1_from_json('[1,0.05,0,0]'), '{K:3}');
4次元のベクトルを5件入れて試し、次の点を確かめました。
CREATE VIRTUAL TABLEで、docs_base・docs_config・docs_idx・docs_idx_idx・docs_meta・docs_modelの6つの補助オブジェクト(sqlite_master上のテーブル・索引)が作られたrebuildの前でも検索は結果を返し、rebuild(flat)の後と同じ結果だったdistanceは2乗したユークリッド距離の値だった(関数リファレンスもvec1_l2_distanceを「ユークリッド距離の2乗」と説明している)。差が0.05のベクトルで0.0025、vec1_l2_distanceで直交する単位ベクトルどうしを比べると2.0を返した。vec1_cos_distanceは1.0PRAGMA integrity_checkはok
距離をそのまま「しきい値」に使う場合は、2乗の値であることを前提に決める必要があります。
codesize 16だけで学習した近似検索は、一致率が低かった
件数が増えたときに速くするため、vec1にはデータから学習した近似検索(ANN)の索引もあります。vec1_train で学習結果を作り、その結果で rebuild します。
-- 学習(codesize は圧縮後の大きさの指定)
SELECT vec1_train(vector, '{codesize:16}') FROM big;
-- 得られた学習結果で索引を作り直す(? に上の結果を渡す)
INSERT INTO big(cmd, vector) VALUES ('rebuild', ?);
384次元のベクトル2万件を、200個の中心のまわりに散らばるよう乱数で作り、20件の問い合わせで上位10件を比べました。全件検索(flat)の結果を正解として、近似検索がどれだけ同じものを返したか(一致率)を見ています。
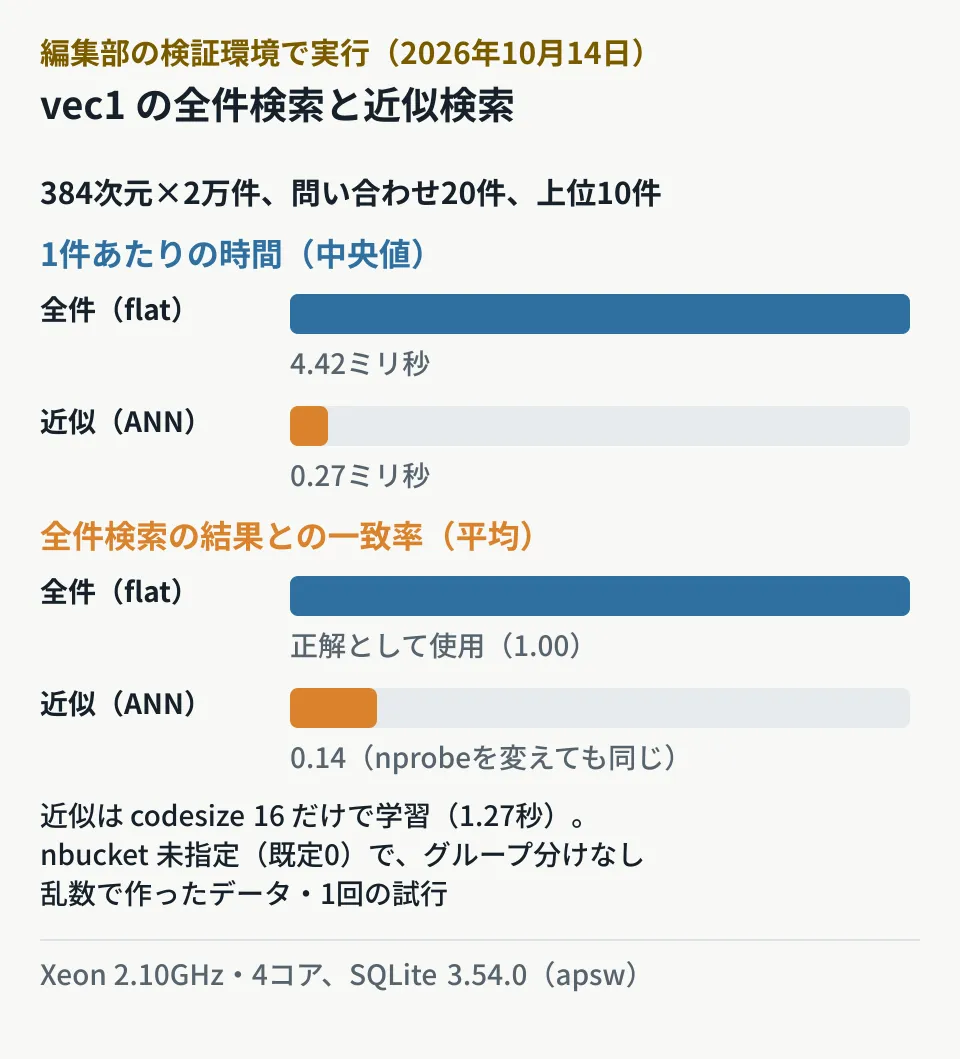
| 検索の方法 | 1件あたり(中央値) | 上位10件の一致率(平均) |
|---|---|---|
| 全件検索(flat) | 4.42ミリ秒 | 正解として使用 |
| 近似検索(codesize 16のみ、nprobe 既定0.05) | 0.27ミリ秒 | 0.14 |
| 同(nprobe 0.2を指定) | 0.16ミリ秒 | 0.14 |
| 同(nprobe 1.0を指定) | 0.15ミリ秒 | 0.14 |
学習は1.27秒、索引の作り直しは0.40秒でした。近似検索は全件検索より1桁以上速い一方、上位10件のうち正解と一致したのは平均1.4件です。調べる範囲を広げる nprobe を上げても一致率は変わりませんでした。
あとで公式の説明(2026年10月16日確認)と照らすと、今回の設定は推奨からずれていました。
- バケット分割を使っていなかった。
vec1_trainのnbucket(データをいくつのグループに分けて探すか)は既定が0で、0のときは分割をせず、圧縮したベクトルを全件調べる、とリファレンスにあります。今回はnbucketを指定していないため、nprobe(調べるグループの割合)が効く仕組み自体を使っていません。一致率がnprobeで変わらなかったのは、このためと考えられます - 圧縮が強すぎた可能性がある。 説明では、圧縮方式
pqのcodesizeは次元数の1/8か1/16(384次元なら48か24)が目安です。今回の16はそれより小さい値でした。最近の埋め込みにはopq方式を勧める記述もあります
設定を変えての再測定はしていないため、推奨どおりの設定でどこまで一致率が上がるかは確かめていません。乱数で作ったデータの1回の結果で、実際の文書の埋め込みで同じになるとは限りません。
採用を考えるなら、先に確かめること
ここからは編集部の提案です。
- 拡張を配れるか。 本番の実行環境で拡張をビルド・配置し、読み込みを許可できるかを確かめる。マネージドなデータベースや、拡張の読み込みを許さない環境では使えない
- 全件検索で足りる件数か。 今回の条件では2万件・384次元の全件検索が1件4〜5ミリ秒でした。社内文書の検索なら、まずflatで要件を満たすかを測り、近似検索は必要になってから検討する
- 近似検索は自社のデータで一致率を測る。
nbucketを明示し、codesizeは説明ページの目安から始めて、全件検索の結果を正解にcodesize・nbucket・nprobeを変えて比べる。速さだけで設定を決めない - 元の文章と埋め込みを別に保存する。 vec1は1.0の前の段階で、補助テーブルの形式にも版番号があります。拡張の更新で作り直しが必要になっても戻れるようにしておく
PostgreSQLを使える環境なら、pgvectorの本番運用も選択肢になります。検索の設計全体はRAG最適化パターン、SQLiteを業務で使うときの前提の置き方は16年見つからなかったSQLiteのバグも参考にしてください。
確認した範囲
2026年10月14日に、GitHubのSQLiteミラー(sqlite/sqlite)から
version-3.54.0タグ(2026年10月9日の「Version 3.54.0」コミット)を取得し、main.mk、ext/vec1/vec1.c、ext/vec1/Makefile、ext/vec1/test/の一部を読みました。そのうえで、上記の環境でvec1.cをビルドし、apsw 3.54.0.0(SQLite 3.54.0)から読み込んで動かしました(実機検証)。10月16日に、SQLite 3.54.0のリリースノートと、vec1の説明ページ・利用ガイド・関数リファレンス・テスト結果のページ(sqlite.org/vec1)を確認しました(資料調査)。データは乱数で作ったもので、実際の文書の埋め込み、Windows・macOS・ARM、古いSQLiteでの動作、nbucketを指定した近似検索やcodesizeを変えた比較は試していません。
社内文書の検索やRAGを既存のシステムにどう組み込むかの検討は、開発・AI・自動化のご相談からお問い合わせください。