請求書のPDF、商品の写真、問い合わせの通話録音。こうしたファイルはCloud Storageにたまっていくのに、売上や顧客の数字はBigQueryにある。両方を突き合わせて分析しようとすると、ファイルを読み取る別の処理を作り、その結果をBigQueryに戻す作業が必要でした。
Google Cloudは2026年10月21日、BigQueryの「ObjectRef」とマルチモーダルの分析機能が一般提供(GA)になったと発表しました。Cloud Storageのファイルを指す列を通常の表に持たせ、SQLからGeminiを呼んで分類や抽出ができる仕組みです。この記事では、公式ブログとBigQueryのドキュメントに書かれた内容を整理し、社内のデータ基盤で使う前に決めておく点をまとめます。
なお、BigQueryのリリースノートには、10月21日付けのObjectRefの項目はありません。リリースノートでは、ObjectRefの関数を自分の権限か接続で動かす機能が3月31日に、AI関数がObjectRefをそのまま受け取る機能が6月12日に、ファイルの一覧からObjectRefを作る OBJ.LIST が9月30日に、それぞれ一般提供になっています。編集部は、ブログを、段階的に一般提供になってきた機能をまとめて発表したものと受け止めています。
ObjectRefとは
ブログは、ObjectRefを次のように説明しています。
ObjectRef is a built-in, predefined STRUCT data type that points to objects outside of BigQuery.
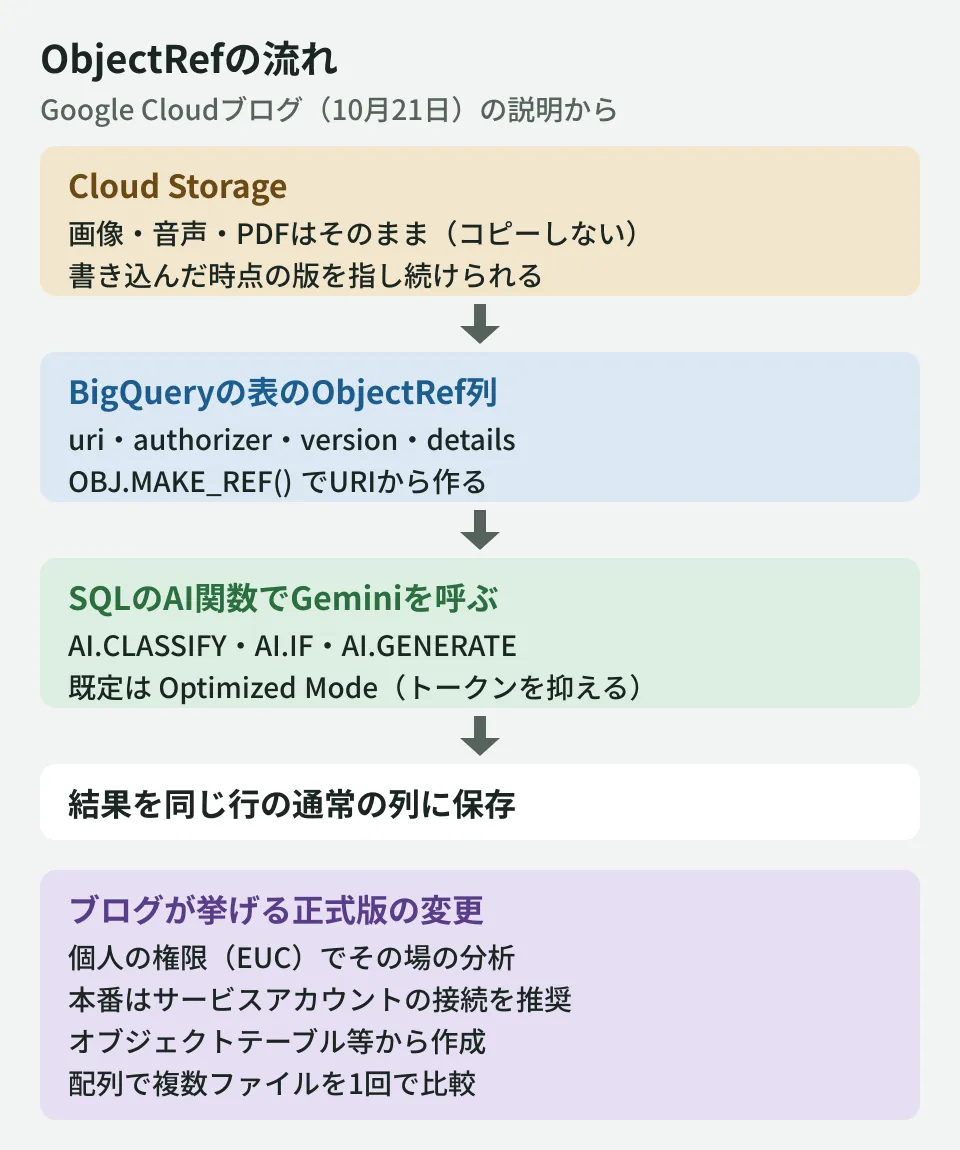
ObjectRefは、BigQueryの外にあるファイルを指す、あらかじめ用意された構造体の型です。中身は、ファイルの場所(uri)、アクセスの権限(authorizer)、版(version)、Cloud Storageのメタデータ(details)です。ファイル自体はCloud Storageに置いたままで、コピーはしません。
ブログには、ファイルが後から書き換わっても、行を書き込んだ時点の版を指し続けられると書かれています。
If the underlying GCS file changes, your query can still reference the exact version of the file that existed when the row was written.
これにより、同じ問い合わせを後から実行しても、同じファイルに対して処理をやり直せます。
SQLでできること
ブログでは、次の3つの使い方が例として示されています。
- 通話録音の分類:
OBJ.MAKE_REF()で音声ファイルのURIからObjectRefを作り、AI.CLASSIFY()で問い合わせの種類に分類して、結果を通常の列として表に保存する - 画像による絞り込み:
WHERE句でAI.IF()を使い、「規約に反する商品が写っているか」といった条件で行を絞り込む - 複数ファイルの比較:ObjectRefの配列を1回のGeminiの呼び出しに渡し、正規のログイン画面と疑わしい画面の画像を比べてフィッシングかどうかを判定する
AI関数はGeminiのトークンを消費します。ブログによると、既定では「Optimized Mode」が使われ、消費するトークンを減らすようになっています。
ブログが挙げる正式版での変更
ブログは、正式版での変更として次の3つを挙げています。
| 変更 | ブログの説明 |
|---|---|
| 個人の権限での問い合わせ | End User Credentials(EUC)で、自分のIAMの権限のまま、その場の分析ができる |
| メタデータの読み込み元 | オブジェクトテーブル、Cloud Storageの Storage Insights のデータセット、通常の表に入ったURIの文字列から作れる |
| 配列への対応 | ObjectRefの配列を扱え、複数の文書や画像を1回で比べられる |
個人の権限での問い合わせは、ドキュメントでは「直接アクセス」と呼ばれています。ObjectRefの authorizer を空(NULL)にすると、問い合わせを実行した人の権限でファイルを読みます。リリースノートでは、この機能は3月31日に一般提供になっています。ドキュメントによると、直接アクセスでは、問い合わせを実行するプロジェクトと同じプロジェクトのバケットしか読めず、AI関数を接続なしで使うには追加の権限も必要です。
ブログは、プレビューのときに必要だったBigQueryの接続(connection)も引き続き使え、サービスアカウントで動かす本番の処理ではそちらを推奨すると書いています。ドキュメントでは、接続を使う方法を「委任アクセス」と呼んでいます。
While these connections remain fully supported and are the recommended best practice for robust, service-account-driven production pipelines, we recognize they require additional setup.
提供範囲は「すべてのBigQueryのエディションと、オンデマンドの料金体系」です。
使う前に決めておくこと
ここからは編集部の整理です。社内のデータ基盤でObjectRefを使う場合、次の点を先に決めておくと、試行から本番へ移るときの手戻りを減らせます。
- 試行と本番で権限の持ち方を分ける:その場の分析は個人の権限(EUC)で始められますが、定期的に動かす処理は、ブログが推奨するとおり接続とサービスアカウントで動かします。ファイルの保存先と分析のプロジェクトが分かれている場合は、直接アクセスでは読めないため、最初から接続を使います。誰の権限でどのバケットのファイルを読めるかを、IAMで整理しておきます
- ファイルの版を残す設計にする:結果を後から検証するために、ObjectRefの列を結果と同じ行に保存します。Cloud Storage側でファイルの古い版を残す設定かどうかも確かめます
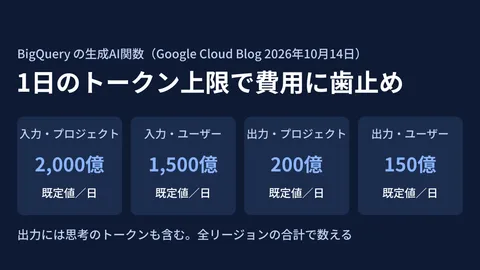
- トークンの上限を先に設定する:数万件のファイルに一度にAI関数をかけると、Geminiの利用料が膨らむおそれがあります。BigQueryのAI関数の日次の上限を、本番の前に設定します
- 小さな表で精度を確かめる:分類の精度は、ファイルの種類や日本語の内容で変わります。数十件で人の判断と比べてから、対象を広げます
AI関数の利用量の上限の設定は、BigQueryのAI関数に日次トークン上限で整理しました。BigQueryをAIのエージェントから使う場合はData Agent Kit正式版 BigQueryをAIに渡す前にを、請求書などの書類から金額を取り出す処理をAIに任せる範囲は請求書の転記をAIに任せる線引きを参照してください。
確認した範囲
2026年10月24日に、Google Cloudの公式ブログ「BigQuery ObjectRef now GA: Build multimodal data platforms for conversational analytics entirely in SQL」(2026年10月21日公開。ページ上の表示は10月22日)をcloud.google.comで直接開いて確認しました(資料調査)。公開前の10月27日に、同じブログと、BigQueryのリリースノート、ドキュメント「Analyze multimodal data」「Work with ObjectRef values」を開いて確かめ直しました。関数の正確な引数と料金の細目は確認していません。編集部はObjectRefを使った問い合わせを実行しておらず、日本語の文書での精度、処理時間、費用は確認していません。
社内のデータ基盤づくりや、ファイルをAIで分析する仕組みの設計は、開発・AI・自動化のご相談からお問い合わせください。