問い合わせの履歴や商品レビューをBigQueryに貯めている会社なら、SQLの中で生成AIを呼び、数万件を一度に分類・要約することができます。便利な反面、テストのつもりで流したクエリが全件に対して生成AIを呼び、翌月の請求で気づく、ということも起こりえます。料金がトークン(AIが処理する文字の単位)の量で決まるためです。
Google Cloudは2026年10月14日(米国時間)の公式ブログで、BigQueryの生成AI関数に対するトークン単位のコスト管理(日次の上限)を紹介しました。BigQueryのリリースノートによると、この機能は2026年6月8日に一般提供(GA)となり、6月15日にいったん設定できなくなったあと、8月31日に復旧しています。この記事では、ブログとBigQueryのドキュメント(Control costs with token quotas)をもとに、上限の種類と、上限に達したときの止まり方、設定の手順を整理します。
4種類の日次上限と既定値
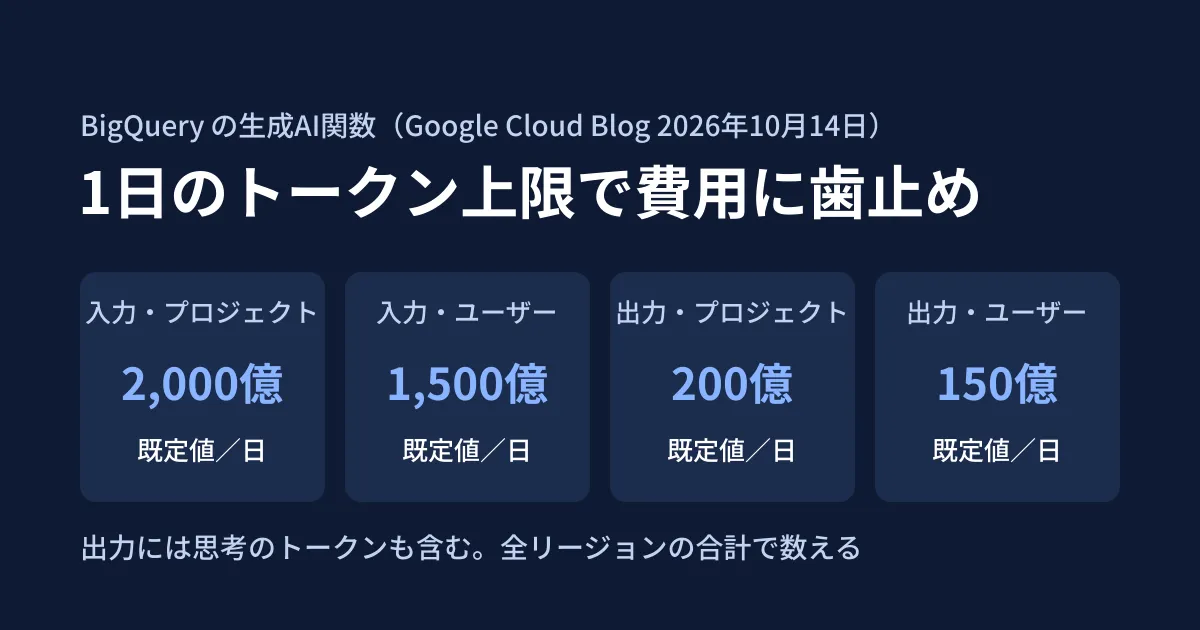
上限は、Google CloudのIAMの割り当て(Quotas)の仕組みで管理され、プロジェクト単位とユーザー単位があります。既定値はブログ、ドキュメント、BigQueryの割り当てのページで同じです。
| 上限の名前 | 数えるもの | 範囲 | 既定値 |
|---|---|---|---|
| AI input tokens per day | 入力トークン | プロジェクトごと・1日 | 2,000億 |
| AI input tokens per day per user | 入力トークン | プロジェクト内のユーザーごと・1日 | 1,500億 |
| AI output tokens per day | 出力トークン(思考のトークンを含む) | プロジェクトごと・1日 | 200億 |
| AI output tokens per day per user | 出力トークン(思考のトークンを含む) | プロジェクト内のユーザーごと・1日 | 150億 |
ブログとドキュメントが挙げている要点は次のとおりです。
- 上限は全リージョンの合計で数える。 普段見ていないリージョンで使われた分も合算される
- 出力の上限には「思考」のトークンも含まれる。 推論のトークンは、Geminiの請求と同じく出力として数える
- ユーザー単位の上限は、プロジェクト内でのユーザーごと。 組織全体でのユーザーごとではない
- 1日の区切りは太平洋時間の午前0時。 日本時間では、夏時間の間は16時、それ以外は17時にリセットされる(ドキュメント)
- キャッシュされたトークンは数えない。 また、使用量は百万トークン単位で集計されるため、数百万トークン未満の細かい値は正確に反映されないことがある(ドキュメント)
- プロビジョンド スループット(処理能力の事前購入)のモデルを使う場合は、請求がトークン量によらないため、上限を高めにしておくよう勧めている(ドキュメント)
既定値は十分に大きな値です。何もしなければ、実質的な歯止めにはならないと考えておくのが安全です。
対象の関数と、対象外の関数
上限が効くのは、生成を行う次の関数です。
AI.GENERATE、AI.GENERATE_TABLE、AI.GENERATE_TEXT(別名ML.GENERATE_TEXT)AI.CLASSIFY、AI.IF、AI.SCORE、AI.AGG
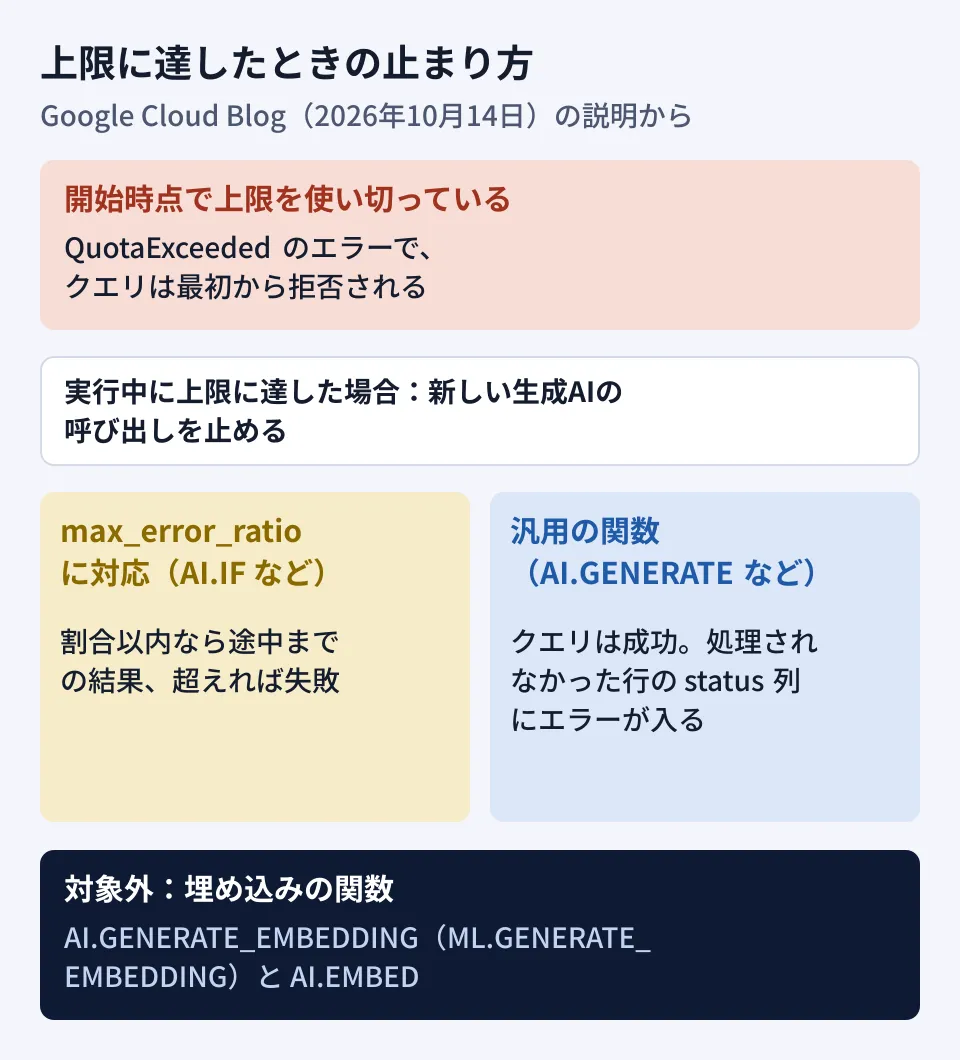
埋め込み(ベクトル化)の AI.GENERATE_EMBEDDING(ML.GENERATE_EMBEDDING)と AI.EMBED は対象外です。ブログは理由を「別の、かなり安いモデルで動くため」と説明しています。ドキュメントは、意味検索の関数も料金体系が違うため対象外としています。
上限に達したとき、処理はどう止まるか
集計の仕組みに組み込むうえで、いちばん確かめておきたいのはここです。ブログによると、上限は「クエリを上限を超えて走らせる」のではなく「処理を止める」形で効きます。
- クエリの開始時点で、必要な上限をすでに使い切っていれば、
QuotaExceededのエラーで最初から拒否される - そうでなければクエリは始まり、途中で上限に達すると、BigQueryは新しい生成AIの呼び出しを止める
max_error_ratioを受け付ける関数(AI.IFなど)は、処理できなかった行の割合がその値以内なら途中までの結果を返し、超えれば失敗する- 汎用の関数(
AI.GENERATEなど)は、クエリとしては成功する。処理されなかった行は生成結果が空になり、statusの列に上限超過のエラーが入る
- 上限を使い切ったあとは、1日の区切り(太平洋時間の午前0時)まで、生成AIの関数を使うクエリが
QuotaExceededで失敗する(ドキュメント)
最後の汎用の関数の点は、集計の作りに直接かかわります。AI.GENERATE を使う集計では、クエリが成功しても全行に結果が入ったとは限りません。結果を別のテーブルに書き出す処理なら、status の列が空でない行を数えて、残りを翌日に回すか知らせる、といった確認を組み込む必要があります。
上限を変える手順と必要な権限
ブログで紹介されている手順は次のとおりです。
- Google Cloudコンソールで「IAM & Admin」→「Quotas & System Limits」を開く(ブログの英語表記。日本語の画面の表記は確認していません)
- サービスで「BigQuery API」を選び、名前の列で並べ替えて4つのAIの上限を探す(ドキュメントでは
GenAiInputTokensPerDayなどの名前で検索する手順も紹介されています) - 対象の上限のメニューから「Edit quota」を選ぶ
上限を下げる変更は承認なしですぐに反映され、上げる場合は同じ画面から申請します(ブログでは「多くは自動で承認され、大きな増加は審査になる場合がある」)。変更には、オーナー、編集者、割り当て管理者(roles/servicemanagement.quotaAdmin)、Service Usage 管理者(roles/serviceusage.serviceUsageAdmin)のいずれかのロールが必要です。Cloud Quotas API、gcloud、Terraformからも設定できると書かれています。同じ画面で、過去のトークンの使用量の推移も確認できます。
上限の値を決める:AI.COUNT_TOKENS
値を決める手がかりとして、ブログは AI.COUNT_TOKENS 関数を紹介しています。この関数は2026年5月12日に追加され、10月19日時点のリファレンスではプレビュー(一般提供の前の段階)です。文字列をモデルのトークナイザーで数えた数を返し、課金される生成の呼び出しは行いません。列に対して実行すれば、入力の量を事前に見積もれます。
ただし、返る数は入力トークンの下限です。出力や思考のトークン、AI関数が入力の周りに付け足す指示、画像などテキスト以外の入力は含まれません。ブログは、小さな標本で実際に流し、入力と出力の使用量を測ってから上限を決めることを勧めています。
ブログには、Gemini 3.1 Flash-Liteで1日の費用を約100ドルに抑える計算例も載っています。ブログ公開時点の料金(BigQueryはバッチ処理のため50%割引)として、入力100万トークンあたり0.125ドル、出力(応答と推論)100万トークンあたり0.75ドル、入力と出力の比を100対1と仮定すると、1日あたり入力約7.54億トークン・出力約754万トークンが目安になる、という例です。この単価は、10月19日時点の料金ページのFlex/Batch・グローバルの価格と同じです(グローバル以外のエンドポイントはこれより1割高い)。料金はモデルと時期で変わるため、実際に設定するときは、その時点の料金表で計算し直します。
請求の上限(spend cap)との違い
ブログは、Cloud Billingの支出の上限(spend cap)との違いにも触れています。トークンの上限は生成AIに特化した予防の仕組みで、BigQueryがクエリの実行中に使用量を数えて上限の手前で止めます。支出の上限は金額でプロジェクトやサービスの単位にかかる広い安全網で、即座には効かないため多少の超過が出ます。ブログの勧めは、トークンの上限を第一の防御、支出の上限をプロジェクト全体の安全網として併用することです。
組み込む前の確認点
ここからは編集部の提案です。
- ユーザー単位の上限から絞る。 ブログも勧めているとおり、1人の試行や暴走したクエリでプロジェクトの予算を使い切らないよう、ユーザー単位の上限を先に下げます。定期実行のサービスアカウントと、分析担当者の個人アカウントで必要な量が違う点も考慮します
statusの列を確かめる処理を入れる。AI.GENERATE系を使う定期集計では、クエリの成功だけで完了としない作りにします- 埋め込みは別に管理する。 埋め込みの関数は上限の対象外です。RAG(社内文書を検索してAIに渡す仕組み)の前処理などで大量に使うなら、別の方法で量を見ます
- 同じプロジェクトの別の処理を洗い出す。 プロジェクト単位の上限は、そのプロジェクトで生成AIの関数を使うすべての処理で共有されます。別の担当者の定期集計などが同じプロジェクトで動いているなら、上限を下げるとその処理も途中で止まりうるため、先に使い道を洗い出してから値を決めます
BigQueryをAIに扱わせる際の権限の考え方はData Agent Kit正式版 BigQueryをAIに渡す前に、分析の置き場所の判断は月次集計が重いからDWHを、の前にで整理しています。
確認した範囲
2026年10月17日に、Google Cloud公式ブログの「Predictable AI spend in BigQuery: Introducing cost management for generative AI functions」(2026年10月14日)を取得し、原文で確認しました(資料調査)。10月19日に、BigQueryのドキュメント(Control costs with token quotas、割り当てのページ、
AI.COUNT_TOKENSのリファレンス)、リリースノート、生成AIの料金ページを開き、GAの日付、既定値、上限に達したときの動き、1日の区切りを照合しました。Google Cloudのプロジェクトでの上限の設定や、上限に達したときの実際の動きは、編集部では試していません。
BigQueryと生成AIを組み合わせたデータ活用の仕組みづくりは、開発・AI・自動化のご相談からお問い合わせください。