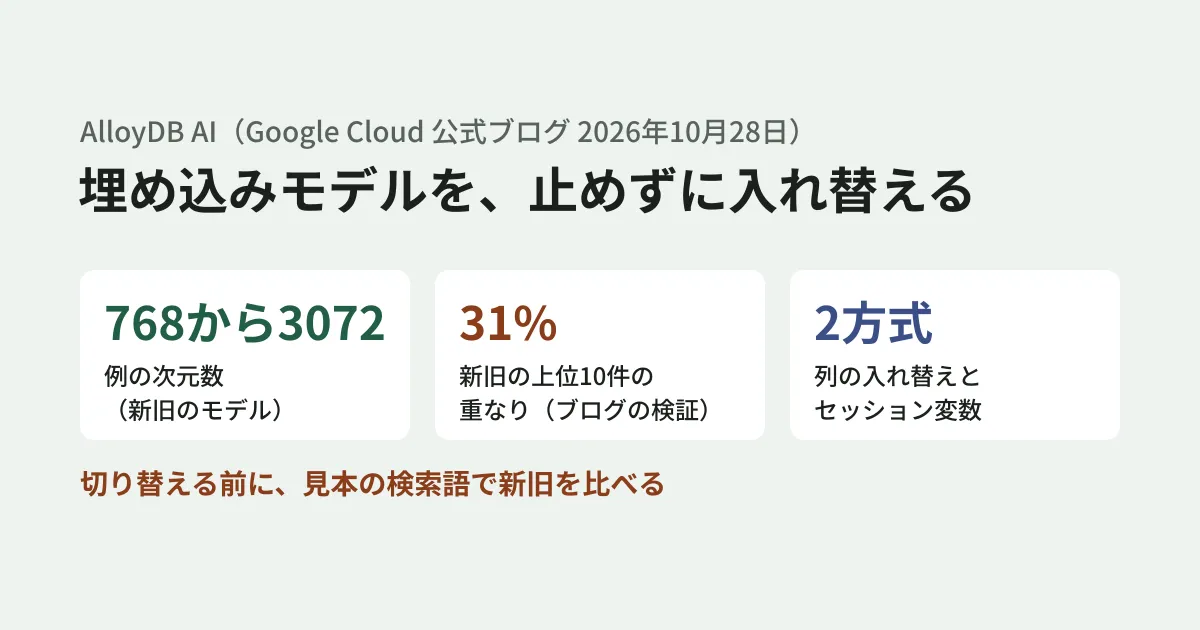
社内文書の検索やRAG(検索拡張生成)を作ったあとで、より精度の高い埋め込みモデルが出た。入れ替えたいが、ベクトルは全件作り直しになり、索引も作り直しになる。その間に検索が止まったり、古いモデルのベクトルと新しいモデルの検索語のベクトルを比べてしまったりすると、検索の結果が壊れます。
Google Cloudは2026年10月28日、AlloyDB AIで埋め込みモデルを停止なしで入れ替える手順を、公式ブログで公開しました。例は、商品レビューの表 ecomm.product_reviews を、text-embedding-005(768次元)から gemini-embedding-001(3072次元)へ、稼働中のまま移すものです。手順の中心になる自動埋め込み(auto vector embeddings)は、2026年3月3日に一般提供(GA)になった機能です。この記事では、ブログの手順を流れに沿って整理し、AlloyDBのドキュメントで確かめた条件を足して、移行の計画で決めておく点を提案します。
入れ替えには期限もあります。Googleのモデルの一覧(2026年11月6日に確認)では、例の移行元の text-embedding-005 と、多言語向けの text-multilingual-embedding-002 の提供終了日は2027年4月1日です。この日付は延びることはあっても、早まることはないとされています。移行先の gemini-embedding-001 は、2028年5月20日より前には終了しません。text-embedding-005 の対応言語は英語なので、日本語の文書を検索している場合は、移行元のモデルを自分の環境のものに読み替えてください。より新しい gemini-embedding-2 もありますが、AlloyDBの組み込み対応モデルの一覧(2026年11月3日更新)には載っていません。
入れ替えで起きる4つの問題
ブログは、本番での入れ替えに伴う問題として、次の4つを挙げています。
- 埋め込みの作り直し: 既存のデータをすべて新しいモデルで埋め込み直す必要がある。新旧のモデルを並べて動かす期間には、両方へ書き込む仕組みも要る
- 数学的な非互換: モデルが違えばベクトルの空間が違い、直接比べられない。検索語のベクトルと保存されたベクトルは、同時にモデルを切り替える必要がある
- 索引の作り直し: 大量のベクトルを効率よく検索するには、新しいベクトルで索引を作り直す必要がある
- 利用者への影響: 何度も行うDDLの変更が排他ロックを取り、読み書きを止めるおそれがある
ブログの手順の流れ
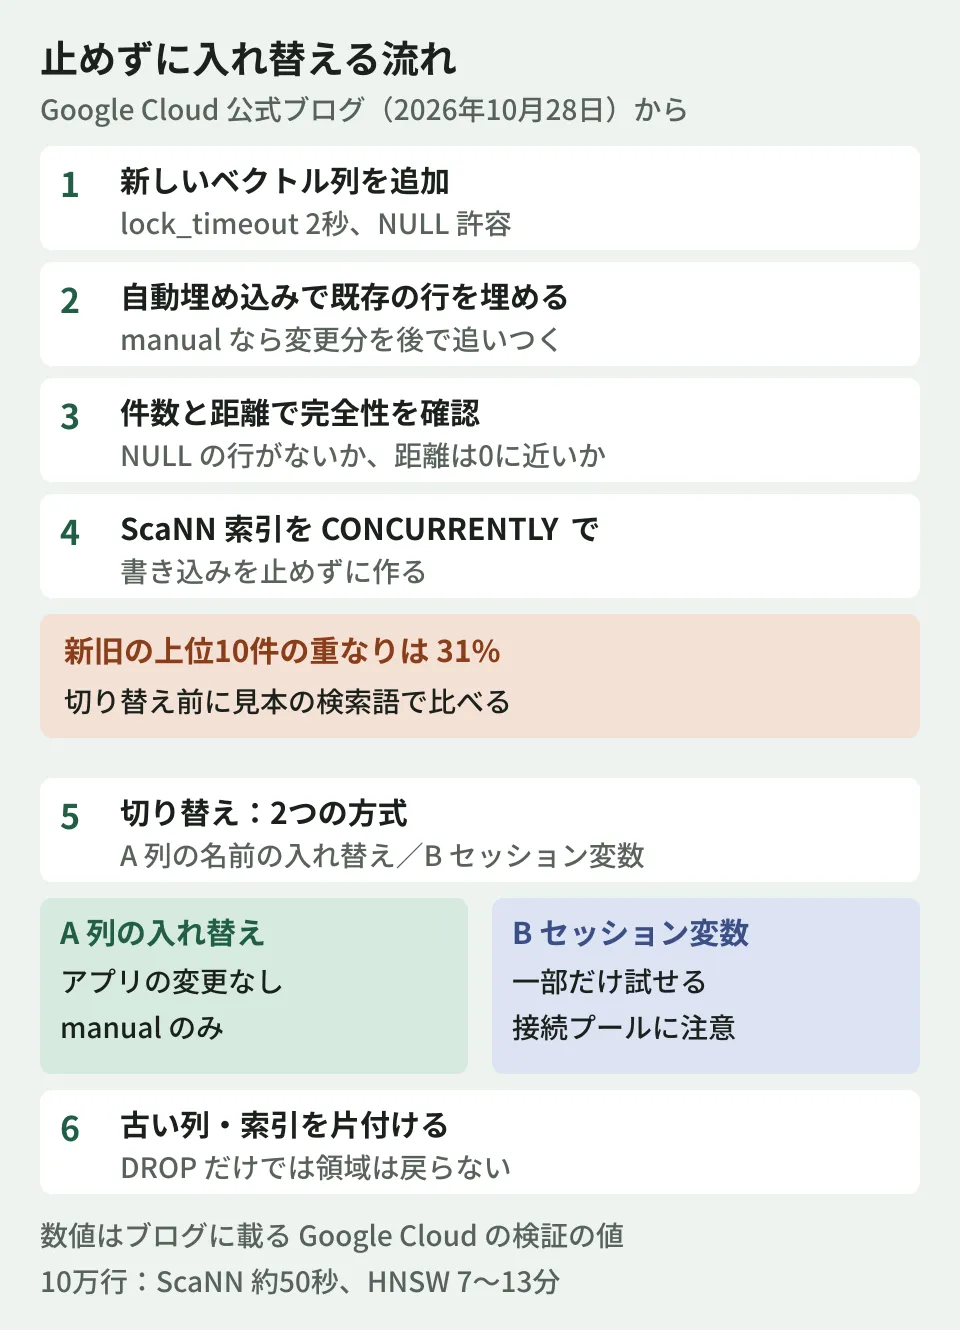
ブログの手順は、準備(Step 0)から片付け(Step 7)までの8段階です。
- 準備:
google_ml_integrationの拡張が1.5.6以上であることを確かめる(ブログは1.6.1で検証)。新しいモデルの出力の次元数(3072)を確かめる。ドキュメントは、google_ml_integration.enable_model_supportとgoogle_ml_integration.enable_faster_embedding_generationの2つのフラグがオンであることも条件にしている。大きな表では既定の割り当て(quota)で処理が絞られることがあるため、先に確かめて増やすよう勧めている - 新しい列を追加: 既定値のないNULL許容の列はメタデータの更新だけで済み、ほぼ一瞬で終わる。
lock_timeoutを2秒にして、ロックの待ちで本番の処理を止めないようにし、失敗したら再試行する - 自動埋め込みで既存の行を埋める:
ai.initialize_embeddingsで新しい列を埋める。更新の方式は2つ。transactionalは書き込みのたびに即時に埋め込みを更新する(書き込みが遅くなる)、manualは変更された行を記録し、後でai.refresh_embeddings()で変更分だけ作り直す。ブログの例はmanualで、ドキュメントではこれが既定 - 変更された行を追いつかせる: 埋める作業の間に変わった行を
ai.refresh_embeddings()で更新する。pg_cronや外部のスケジューラで定期的に実行する - 完全性と検索の質を確かめる: 新しい列がNULLの行の数と、新しく埋め込んだ値との距離(0に近いはず)を確かめる。本番では書き込みが続くため、ブログは追跡用の列(
google_ml_track_stale_embedding)で、最後の更新の後に変わっていない行だけに絞っている。列の名前は表によって違うことがある - 新しいScaNN索引を作る:
CREATE INDEX CONCURRENTLYで、書き込みを止めずに作る。3072次元では索引の作成にメモリが多く要るため、例ではmaintenance_work_memを1GBにしている - 検索の切り替え: 後述の2つの方式から選ぶ
- 古いモデルの片付け: 古い列の自動埋め込みの設定と索引を消し、ディスクの領域を回収する
ブログは、埋める作業の速さを最大で毎秒3,000件、ScaNN索引の作成をオープンソースのHNSWより最大10倍速いと説明しています。10万行の検証では、3072次元のScaNN索引が約50秒で、halfvecを使うHNSWの索引は7〜13分だったとしています。いずれもGoogle Cloudの検証の値で、編集部では計測していません。
止めなくても、負荷と費用はかかる
検索を止めずに済んでも、移行の間の負担がなくなるわけではありません。ブログとドキュメントから、計画に入れておきたい点を挙げます。数値はいずれもブログに載っているGoogle Cloudの検証の値です。
- 書き込みの待ち: 埋める作業の間、同時に行う更新や削除は、処理中のまとまりの確定を待ちます。1万行の検証では、既定の
max_parallel_requests(400)で最長5.1秒待ちました。20に下げると待ちは0.39秒になり、全体の時間は5.2秒から7.6秒に延びました - ディスク: 新旧の列が並ぶ間、領域が増えます。ブログの目安は、新しい列が1行あたり約13.3KB(古い列の約3倍)、ScaNN索引が約0.6KB、これにWALなどの余裕として約25%を足します。1,000万行なら、新しい列に約133GB、索引に約6GBです
- 費用: ドキュメントによると、AlloyDBはAI関数の呼び出しに課金しませんが、モデルの提供元の料金はかかります。全件を埋め直す分も見積もっておきます
切り替える前に、検索の結果が変わることを前提にする
ブログは、社内の比較で text-embedding-005 と gemini-embedding-001 の上位10件の結果の重なりが31%しかなかったと書いています。ブログはこれを、新しいモデルの意味の捉え方が細かいことの表れとしつつ、アプリケーションの前提に影響し得るため、本番の検索を新しい埋め込みへ回す前に、見本の検索語(golden queries)でオフラインの試験をするよう勧めています。
ここからは編集部の提案です。上位10件の7割近くが入れ替わるなら、利用者から見た「検索の結果」は別物になります。見本の検索語には、業務でよく使う検索語と、正解とする文書の組を用意し、新旧の列で結果を比べておきます。RAGで回答を作っている場合は、回答の根拠になる文書が変わるため、回答の評価もやり直します。
索引の検索の設定も結果を左右します。ブログの検証では、scann.num_leaves_to_search を既定値から25に上げると、Recall@10が0.35から0.95になり、検索の遅れは8.8ミリ秒でした。既定値のまま比べると、新しいモデルの精度を低く見誤るおそれがあります。
2つの切り替え方
| 方式 | 仕組み | 向き・制約 |
|---|---|---|
| A:列の名前の入れ替え | 検索語の埋め込みを作る関数を挟み、1つのトランザクションで列の名前と関数のモデルを入れ替える | 検索語の埋め込みをこの関数で作る形にしてあれば、切り替えのときのアプリケーションの変更は要らない。manual の方式のみ。全量の切り替えだけで、一部の利用者だけに試すことはできない |
| B:セッション変数と関数 | app.embedding_model というセッション変数で、新旧どちらの列を検索するかを関数の中で選ぶ | 一部のセッションだけ新しいモデルへ振り分ける試験(カナリア)や、即時の戻しができる。transactional の方式にも対応 |
方式Aでは、戻すときは列の引数を逆にして同じ手順を呼べばよい、とブログは書いています。方式Bには、接続プールの注意があります。PgBouncerをトランザクションモードで使うと、普通の SET はプールのサーバー側の接続に残り、ほかのクライアントへ漏れたり、自分の後のトランザクションに効かなかったりします。ブログは、明示的なトランザクションの中で SET LOCAL を使うか、PgBouncerをセッションモードで使うよう勧めています。
transactional の方式で自動埋め込みを使っている場合は、手順が3点変わります。変更分の追いつき(上の4)が要らない、列の名前の入れ替え(方式A)は使えない(自動埋め込みのトリガーが列名を固定で参照するため、書き込みが失敗する)、移行の間は1回の書き込みごとに外部の埋め込みの呼び出しが2回になり、書き込みが遅くなる、の3点です。ブログの検証では、1行の更新にかかる時間の中央値は、移行前の約37.5ミリ秒が、移行中に約191ミリ秒、切り替え後に約172ミリ秒になりました。ドキュメントも transactional を、デモや小さなデータ、更新の少ない表に向く方式と説明しています。
片付けで、領域はすぐには戻らない
古い列を ALTER TABLE ... DROP COLUMN で消しても、PostgreSQLのTOASTの領域は、データのページが書き直されるまでディスクに残ります。ブログは、古い列を少しずつNULLにしてからVACUUMし、その後に列を消す手順を示しています。10万行の検証では、381MBのTOASTの領域を再利用できるようになったとしています。この方法は全行の新しい版を作るため、VACUUMの負荷とのかね合いで、すぐに領域を回収するかを決めるよう、ブログは書いています。
pgvectorで本番の検索を運用するときの全体の注意はpgvector本番運用ガイドで、AlloyDBを本番から切り離してAIに読ませる考え方はAIエージェントに本番DBを読ませる — AlloyDB新プレビューで扱いました。
確認した範囲
2026年11月6日に、Google Cloud公式ブログの「How to upgrade embedding models in AlloyDB AI with zero downtime」(2026年10月28日)と、AlloyDBのドキュメント(自動埋め込み、ScaNN索引、対応モデル、リリースノート)、Googleのモデルの一覧を開いて確認しました(資料調査)。拡張の1.5.6以上という条件、
manualとtransactionalの違いは、ドキュメントと一致しています。毎秒3,000件、10倍、31%などの数値はブログに載っているGoogle Cloudの検証の値で、ドキュメントでは確かめられません。AlloyDBのクラスタを作っての検証はしていません。切り替えの前の評価の進め方は、編集部の提案です。
社内検索やRAGの埋め込みモデルの入れ替え、検索の評価の設計は、開発・AI・自動化のご相談からお問い合わせください。
参考資料
- How to upgrade embedding models in AlloyDB AI with zero downtime(Google Cloud Blog、2026年10月28日)
- Generate and manage auto vector embeddings for large tables(AlloyDBのドキュメント)
- AlloyDB for PostgreSQL release notes(2026年3月3日の項)
- Supported AI models(AlloyDBのドキュメント)
- Model versions and lifecycle(Googleのモデルの一覧)