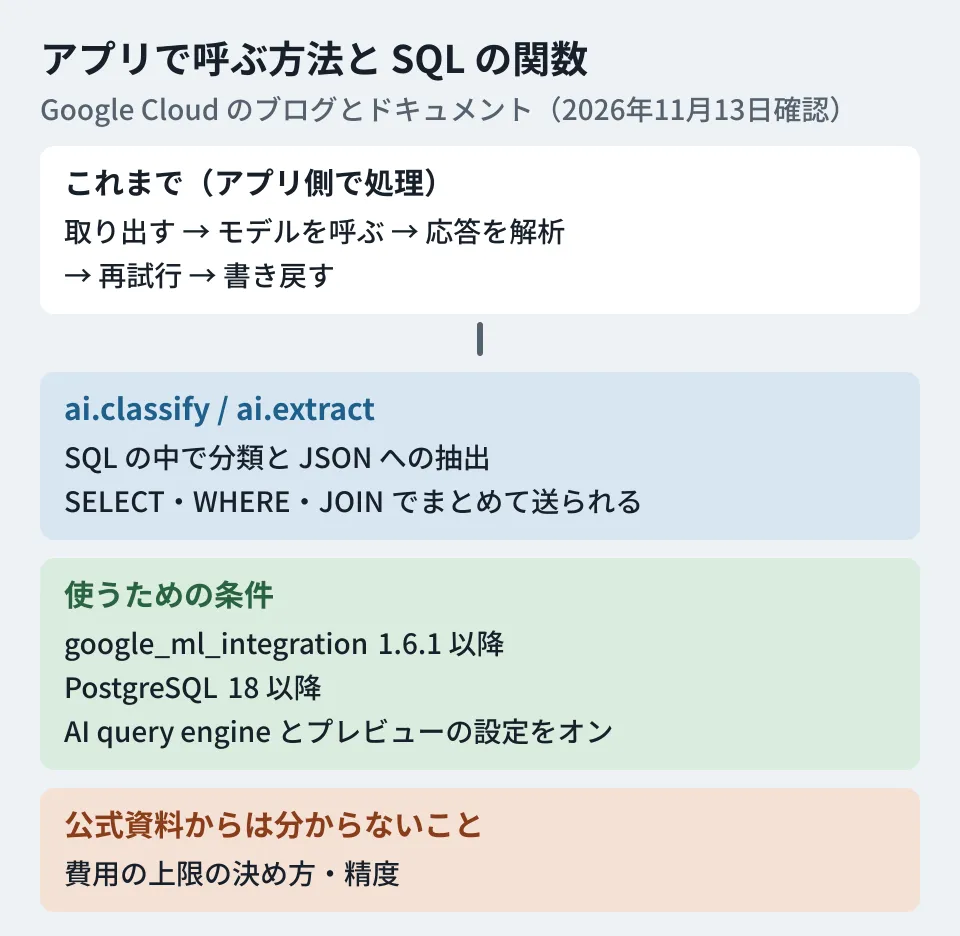
問い合わせフォームの本文や請求書の明細のテキストは、データベースに入ったまま、人が読んで分類したり転記したりしていることがあります。生成AIで自動化しようとすると、データを取り出してモデルのAPIを呼び、返ってきた答えを解析して書き戻すプログラムが要り、再試行やエラーの処理も自前で持つことになります。
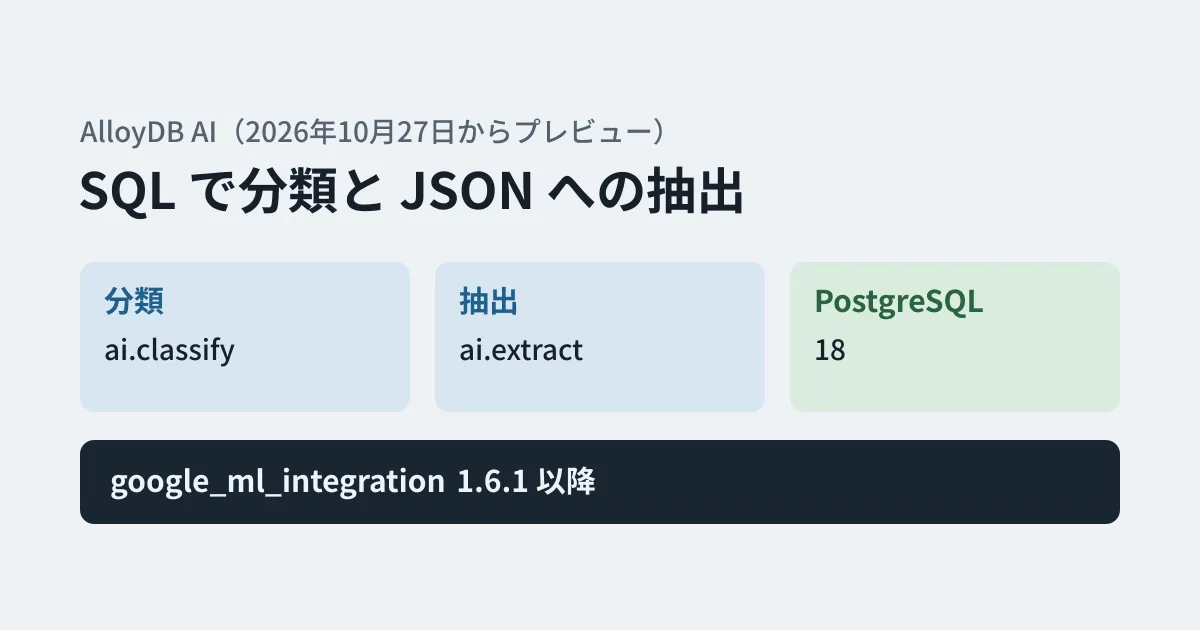
PostgreSQL互換のデータベースAlloyDBの「AlloyDB AI」に、SQLからテキストを分類する ai.classify と、テキストからJSONを取り出す ai.extract が、プレビューとして加わりました。AlloyDBのリリースノートでは2026年10月27日の項目に載り、Google Cloudの公式ブログは11月12日に紹介しています。本記事では、ブログとドキュメントに書かれている条件と書き方を整理し、自前のプログラムで同じことをする場合との違い、業務のデータに使う前に決めておくことをまとめます。資料での確認で、関数の実行は行っていません。
使うための条件
ドキュメント(「Classify text」「Extract structured data」。いずれも2026年11月10日更新)に書かれている条件は次のとおりです。版とPostgreSQLの条件は、ブログの記述とも合っています。
- PostgreSQL 18以降(ブログの表記は「PostgreSQL 18」)
- AlloyDBの
google_ml_integration拡張のバージョン1.6.1以降 - AI query engine とプレビューの関数を有効にする2つの設定(どちらも既定はオフ。データベースの再起動は不要)
- 提供段階はプレビュー(Pre-GA Offerings Terms の対象で、「as is」で提供され、サポートが限られることがある)
SET google_ml_integration.enable_ai_query_engine = 'on';
SET google_ml_integration.enable_preview_ai_functions = 'on';
ブログの例は SET google_ml_integration.enable_preview_ai_functions = TRUE; の1行だけですが、ドキュメントは上の2つの設定を挙げています。セッションごとに設定するほか、ALTER DATABASE で特定のデータベースに、インスタンスのデータベースフラグですべてのデータベースに設定する方法も示されています。
行ごとの呼び出しをまとめてモデルに送る「smart batching for AI functions(AI function acceleration とも呼ばれる)」も使えます。リリースノートでは、smart batching は2026年11月9日に、PostgreSQL 17以降のクラスタで ai.classify・ai.extract を含む関数向けに一般提供になりました(ai.classify・ai.extract 自体はプレビューのままです)。smart batching のドキュメントによると、次のように動きます。
- PostgreSQL 18では既定でオン(設定は
google_ml_integration.enable_ai_function_acceleration) ai.classify・ai.extractは、SELECTの列、WHERE、JOINの中でまとめて送られる- AIを使わない通常の絞り込みの条件を先に評価し、それを通った行だけをモデルに送る
- 前提として、Gemini Enterprise Agent Platform との連携(AlloyDBのサービスエージェントに Vertex AI User のロールを付ける)が要る
- 使える地域は、既定のモデル(または設定したモデル)が使える地域
ブログは WHERE 句で使う場合を例に、1行ずつ評価するより速く、プロンプトの重複を減らしてトークンの費用も下げると説明しています。
関数の書き方
ai.classify は、指定した分類のどれに当たるかを返します。ブログとドキュメントに挙がっている機能は次のとおりです。
- 1つだけ選ぶ(
output_mode => 'single')か、当てはまるものをすべて返す(output_mode => 'multi')か - 分類の名前だけでなく、2次元の配列で各分類の説明を渡せる
- 例を渡すfew-shotの指定(
examples) - 1行(
TEXT)、配列(TEXT[])、カーソル(REFCURSOR)の3通りの入力。配列とカーソルではbatch_sizeを指定できる(配列の既定は10) model_idで使うモデルを指定できる。事前に登録されたモデルのほか、自分で登録したモデルも指定できる
ブログとドキュメントの例は、商品レビューを「positive / neutral / negative」に分けるものです。分類ごとに説明を付け、batch_size => 5 を指定しています。ドキュメントの出力例は、3件のレビューに対して positive・negative・negative でした。
SELECT unnest(
  ai.classify(
    inputs => ARRAY(SELECT review FROM product_reviews ORDER BY id),
    categories => ARRAY[
      ['positive', 'Good sentiment'],
      ['neutral', 'Neither good nor bad sentiment'],
      ['negative', 'Bad sentiment']
    ],
    batch_size => 5
  )
) AS sentiment;
ai.extract は、テキストから指定した項目を取り出し、JSONで返します。項目はJSONスキーマか、取り出したい項目を書いた文章で指定します。ブログの例は、診療メモから患者名・年齢・症状・処方薬を取り出すもので、output_schema に型を付けたJSONスキーマを渡しています。いずれの例でも、プロンプトの文面や応答の解析のコードは書いていません。
業務での使い方として、ブログは請求書のテキストからの取引先・日付・明細の合計の抽出、契約書からの準拠法・責任の上限・解約の通知期間の抽出などを挙げています。
model_id を省略したときの既定のモデルは、資料によって書き方が違います。分類・抽出のドキュメントは gemini-3.5-flash-lite、smart batching のドキュメントは gemini-2.5-flash-lite と書いています。リリースノート(2026年10月29日)には、拡張のバージョン1.6.5で既定のGeminiモデルが gemini-3.5-flash-lite になり、gemini-2.5 系のモデルが事前登録の一覧から外れたとあります。拡張の版によって既定が変わるため、業務で使うときは model_id を明示しておくと、どのモデルで出した結果かを後から追えます(編集部の提案)。
自前のプログラムで呼ぶ場合との違い
ブログは、アプリ側でモデルを呼ぶ方法の負担として、データの取り出し、外部のモデルの呼び出し、プロンプトの組み立て、予測できない応答の解析、再試行、データの書き戻しを挙げ、待ち時間・コードの量・トークンの費用・データが複数のネットワークの境界をまたぐことによるコンプライアンス上のリスクにつながると書いています。
これを編集部で整理すると、SQLの関数にする利点は、分類・抽出の結果をそのまま表に書き込めることと、データベースの外にプログラムを置かずに済むことです。一方で、次の点は自前のプログラムのほうが制御しやすい可能性があります。
| 観点 | SQLの関数(ai.classify / ai.extract) | 自前のプログラム |
|---|---|---|
| 使うモデルの選択 | model_id で指定(登録したモデルも可) | 任意に選べる |
| 費用の上限 | AlloyDB側で上限を決める設定は、今回読んだドキュメントには書かれていない | 呼ぶ回数・トークンを自分で制御 |
| 結果の検証 | 呼ぶ側のSQLで確かめる | 解析の段階で弾ける |
| 提供段階 | プレビュー(smart batching は一般提供) | モデルのAPIの提供段階による |
料金について、AlloyDBの料金のページは「AlloyDB AI is available at no additional charge. Customers making calls to AI models will be billed through the model provider.」と書いています。AlloyDB AIの機能そのものに追加の料金はなく、モデルの呼び出しの料金はモデルの提供元から請求されます。smart batching のドキュメントは、モデルのトークンの割り当て(TPM)やAgent PlatformのAPIの上限を超えると、HTTP 429 のエラーになることがあると書き、並列の度合いやまとめる件数を下げる設定を示しています。ブログは今後の予定として、コストの最適化、行ごとの出どころ(provenance)の追跡、WHERE 句以外への処理の押し下げを挙げています。
BigQueryで同じような生成AIの関数を使うときのトークンの上限の考え方はBigQueryのAI関数の日次トークン上限の記事で、AlloyDB AIで埋め込みのモデルを入れ替える手順はAlloyDB AIの埋め込みモデルの記事で扱いました。
業務のデータに使う前に決めること(編集部の提案)
ここからは、ブログとドキュメントの内容をもとにした編集部の提案です。
- 結果を別の列に保存し、元のデータを書き換えない。 分類や抽出の結果は、元のテキストとは別の列や表に、実行した日時、使ったモデル、関数の設定(分類の一覧やスキーマ)とともに保存します。設定やモデルを変えたときに、どの結果が古いかを区別できます。
- 人が確かめる範囲を決める。 請求書の金額や契約の条件のように、誤ると業務に影響する項目は、抽出の結果を人が確かめてから使う流れにします。分類は、確信が持てないものを「その他」に入れる分類を用意しておくと、人が見る対象を絞れます。
- 対象の行を絞ってから試す。 smart batching でまとめて送られても、関数を評価する行が多ければ、そのぶんモデルを呼ぶことになります。ドキュメントによると、日付などAIを使わない条件を通った行だけがモデルに送られます。先に日付や状態で絞った範囲で試し、どれだけ時間と費用がかかるか、割り当ての上限に当たらないかを確かめてから広げます。
- 個人情報を含むテキストの扱いを確かめる。 ブログはデータをデータベースの中に留められる点を利点に挙げていますが、関数はテキストをモデル(既定ではAgent PlatformのGemini)に送って処理します。モデルへ送られる経路や保存の扱いは、Agent Platformのドキュメントと契約で確かめてください。
- プレビューの条件を確かめる。 プレビューの機能は、提供条件やサポートの範囲が一般提供と異なります。リリースノート(2026年10月27日)では、同じAI query engineの別の関数(
ai.analyze_sentiment・ai.summarizeなど)で引数の名前が変わっており、プレビューの間は書き方が変わる可能性もあります。本番の処理に組み込む前に、Google Cloudの条件とリリースノートを確かめます。
確認した範囲
2026年11月12日にGoogle Cloudの公式ブログ「Introducing new AI functions for AlloyDB: ai.classify and ai.extract」(2026年11月12日)を確認し、11月13日にAlloyDBのリリースノート(10月27日・10月29日・11月9日の項目)、ドキュメント「Classify text」「Extract structured data」「Accelerate performance for queries with AI functions」(いずれも11月10日更新)、Agent Platformとの連携の手順、料金のページを確認しました(資料調査)。関数の実行は行っていません。分類・抽出の精度、モデルのトークンの単価は確認していません。
問い合わせや帳票のデータを生成AIで分類・転記する仕組みづくりは、グリームハブの開発・AI・自動化のご相談で承っています。データの量や確かめ方によって構成が変わるため、お問い合わせからご相談ください。
参考資料
- Google Cloud Blog — Introducing new AI functions for AlloyDB: ai.classify and ai.extract
- AlloyDB for PostgreSQL release notes
- AlloyDB — Classify text
- AlloyDB — Extract structured data
- AlloyDB — Accelerate performance for queries with AI functions
- AlloyDB — Integrate with Gemini Enterprise Agent Platform
- AlloyDB pricing