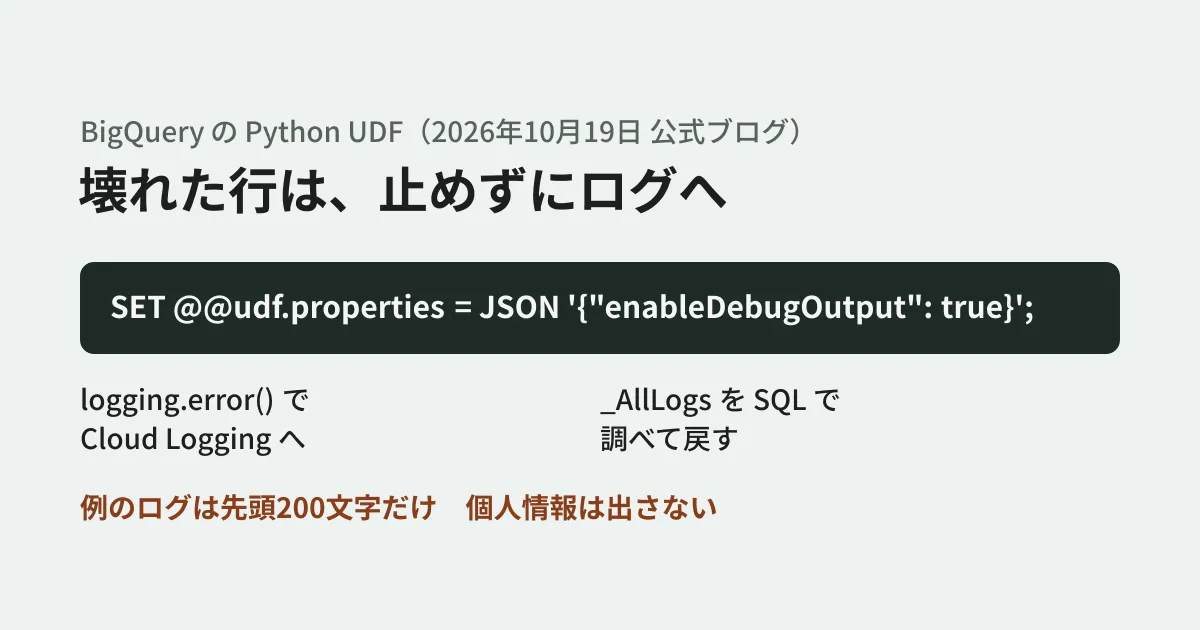
外部のシステムやWebのフォームから届くJSONを、BigQueryで毎日取り込んでいる。1行でも壊れたデータが混ざるとクエリ全体が失敗し、朝の集計が止まる。かといって、壊れた行を黙って捨てると、何が欠けたのか後から分からない。
Google Cloudは2026年10月19日、BigQueryのPython UDF(ユーザー定義関数)の中で、Pythonの標準の logging を使い、構造化したログをCloud Loggingへ送れる機能を公式ブログで紹介しました。外部のプラグインや独自のコネクタは要らないとしています。BigQueryのリリースノートでは、Python UDFは2026年5月20日に、Cloud Loggingでログを見る機能は8月26日に、一般提供(GA)と案内されています。この記事では、ブログが示す「壊れた行を止めずに外し、通知し、調べて戻す」流れと、例をそのまま本番に使う前に直しておきたい点を整理します。
ブログの例:3つの段階
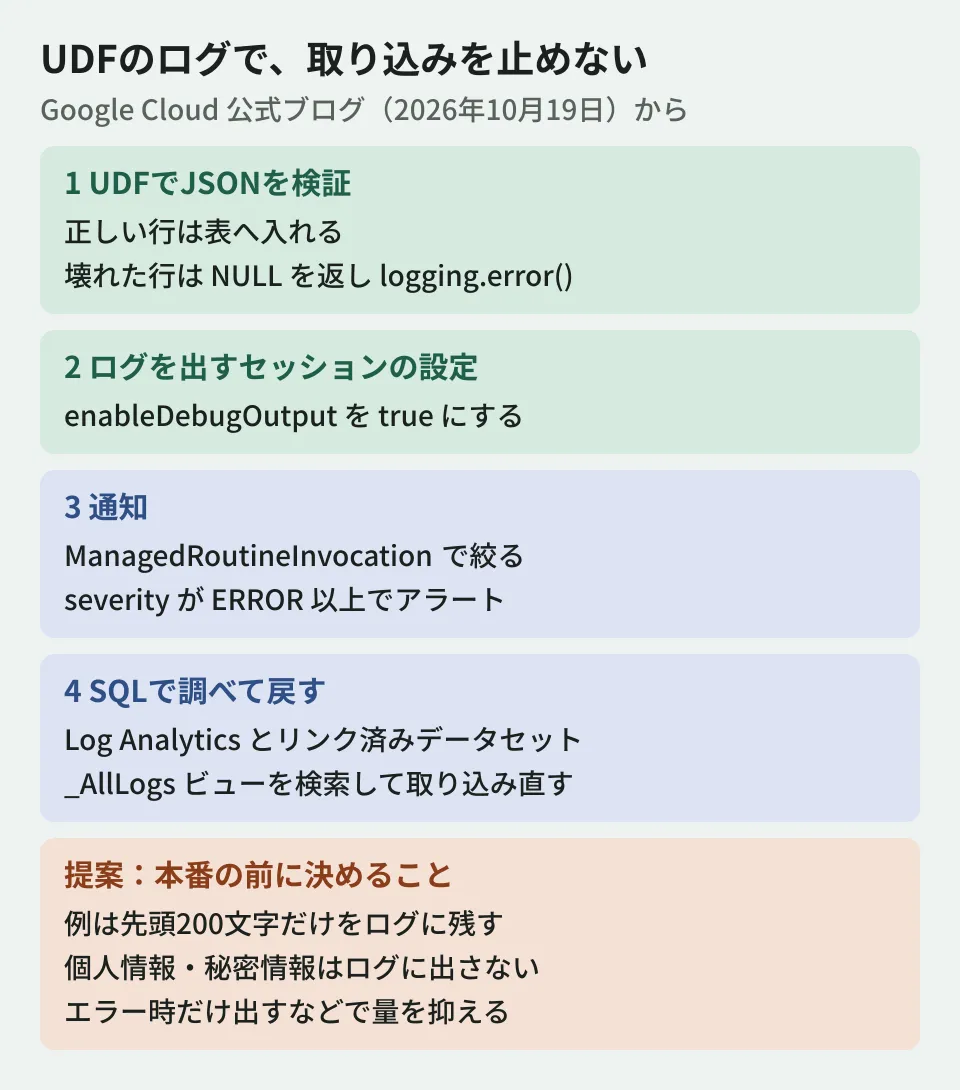
ブログは、ECサイトの利用者の操作(click、view、checkout)のイベントを取り込む例で、次の3段階を示しています。
- 取り込みの中で検証する: Python UDFがJSONを解析する。正しい行は取り込み先の表へ、壊れた行や必須の項目がない行は
logging.error()でログに出し、NULLを返してクエリの失敗を防ぐ - すぐに通知する: Cloud Monitoringのログベースの指標とアラートで、エラーの件数が基準を超えたら担当者に知らせる
- SQLで調べて戻す: Cloud Loggingのバケットにリンクしたデータセットの
_AllLogsビューを、BigQueryのSQLで検索し、原因を調べて、直したデータを取り込み直す
手順の要点
UDFの中でログを出す
ブログのUDF safe_parse_json は、受け取った文字列が空なら logging.warning()、必須の項目がなければ MISSING_REQUIRED_KEY、JSONとして読めなければ JSON_SYNTAX_ERROR を、それぞれJSONの文字列にして logging.error() で出し、NULLを返します。ランタイムは python-3.11 です。
CREATE OR REPLACE FUNCTION `YOUR_PROJECT.YOUR_DATASET.safe_parse_json`(
    raw_payload STRING,
    required_key STRING
)
RETURNS STRING
LANGUAGE python
OPTIONS (entry_point='safe_parse_json', runtime_version='python-3.11')
AS r'''
import json
import logging

def safe_parse_json(raw_payload, required_key):
    if not raw_payload or raw_payload.strip() == "":
        logging.warning(json.dumps({"error_type": "EMPTY_PAYLOAD"}))
        return None
    try:
        data = json.loads(raw_payload)
        if required_key and (required_key not in data or data[required_key] is None):
            logging.error(json.dumps({
                "error_type": "MISSING_REQUIRED_KEY",
                "missing_key": required_key,
                "raw_payload": raw_payload[:200]
            }))
            return None
        return json.dumps(data)
    except Exception as e:
        logging.error(json.dumps({
            "error_type": "JSON_SYNTAX_ERROR",
            "error_message": str(e),
            "raw_payload": raw_payload[:200]
        }))
        return None
''';
セッションでログの出力を有効にする
ログは、取り込みのクエリを実行するセッションで、次の設定をしたときに記録されます。ブログのベストプラクティスにも「ログを残したいセッションに含める」と書かれています。
SET @@udf.properties = JSON '{"enableDebugOutput": true}';ドキュメントによると、Python UDFのログは、意図しないデータの持ち出しを防ぐため既定でオフです。ログは logging.info や logging.error などで出します。print() には対応していません。
ブログの例では、4件のうち壊れたJSONの行と user_id のない行の2件がCloud Loggingへ送られ、クエリは止まらずに残りの2件が clean_events の表に入ります。
通知と検索の条件
アラートは、ログエクスプローラーで次の条件を貼り付け、「アラートを作成」から通知先(Slack、PagerDuty、メールなど)を設定します。
resource.type="bigquery.googleapis.com/ManagedRoutineInvocation"
severity>=ERROR
この手順で作るログベースのアラートは、条件に合うログを知らせるものです。ドキュメントによると、ログベースのアラートでは件数を出せず、件数にはログベースの指標を使います。「エラーの件数が基準を超えたら」という形にするなら、ログベースの指標を作り、その指標にアラートを設定します。
SQLでの検索には、Cloud LoggingのバケットでBigQuery Log Analyticsを有効にし、リンクしたデータセットを作っておく必要があります。ブログの例は、_AllLogs ビューを log_name LIKE '%managed_routine_output%' で絞り、json_payload の error_type・missing_key・raw_payload を取り出しています。
例をそのまま使う前に直す点
ブログの例は機能を示すための最小限の形です。本番の取り込みに使う前に、次の点を決めておくことを編集部として提案します。
ログに残す長さと、戻す手段を合わせる。 ブログは「元のデータがCloud Loggingに残るため、SQLで戻せる」と説明していますが、例のUDFは raw_payload[:200] で先頭の200文字だけをログに出しています。200文字を超える行は、ログからは元に戻せません。ログのバケットの保存の期間も、変更しなければ30日です。戻す前提なら、元のデータを別の表やCloud Storageに残し、ログには行を特定するIDとエラーの種類だけを出す形も検討します。
個人情報をログに出さない。 ブログのベストプラクティスは、Cloud LoggingがLogging Viewerの権限を持つ利用者に見えるため、資格情報や秘密情報をログに出さないよう求めています。Webのフォームや会員のデータでは、メールアドレスや氏名も同じ扱いにし、ログに出す項目を決めておきます。ドキュメントも、ログを見る権限があれば、BigQueryの元データへの権限がなくても記録された内容を見られると注意しています。リンクしたデータセットへの問い合わせはBigQueryの権限で判断され、特定のビューだけに絞ることはできません。ログを閲覧できる人と、リンクしたデータセットの権限をあわせて確かめます。
ログの量と費用を見積もる。 ブログは、流量の多いパイプラインでは、エラーの時だけ出す、標本を取るなどして、ログの取り込みの量を抑えるよう書いています。Cloud Loggingの取り込みは1GiBあたり0.50ドルで、プロジェクトごとに毎月50GiBまでは無料です(2026年11月6日の料金ページ)。Python UDFには、コンテナのビルドと呼び出しの費用もかかり、クエリの結果はキャッシュされません。壊れた行が急に増えたときの量も想定しておきます。
戻すSQLは文を分ける。 ブログの戻しの例は、INSERT と確認の SELECT の間にセミコロンがありません。また、user_id に default_user を入れる代替の値の決め方は、集計の意味を変えます。戻すときの値は、取り込み元の担当者と決めておきます。
ブログは他の使い方として、新旧の計算を並べて差分だけをログに出す移行の確認、マスキングの監査のイベント、モデルの推論での想定外の入力の警告も挙げています。
BigQueryで生成AIの関数を使う場合の上限の設定はBigQueryのAI関数のトークン上限の記事、Cloud Storageのファイルを扱う場合はBigQuery ObjectRefの記事を参照してください。
確認した範囲
2026年11月3日と6日に、Google Cloud公式ブログの記事「How to Use Python UDF Logging for Pipeline Observability」(配信データの公開日は2026年10月19日、ページの表示は10月20日)を直接取得し、手順・設定・SQL・ベストプラクティスを原文と照合しました(資料調査)。コードはブログの例を、意味を変えずに空行だけ詰めて載せています。11月6日に、BigQueryのリリースノートとPython UDFのドキュメント、Cloud Loggingのドキュメントと料金ページも確かめました。ブログの
log_name LIKE '%managed_routine_output%'の条件はドキュメントでは確かめられていません。BigQueryでの実行の検証はしていません。
データの取り込みや集計の仕組みづくりは、開発・AI・自動化のご相談からお問い合わせください。
参考資料
- How to Use Python UDF Logging for Pipeline Observability(Google Cloud Blog、2026-10-19)
- Work with user-defined functions in Python(BigQuery)
- BigQuery release notes
- Create a linked BigQuery dataset on a log bucket(Cloud Logging)
- Configure log buckets(Cloud Logging)
- Configure log-based alerting policies(Cloud Logging)
- Google Cloud Observability pricing